

 Spanish (pdf)
 Article in xml format
 Article references

 Automatic translation
 Send this article by e-mail
 Cited by SciELO
 Cited by Google
 Similars in
SciELO
 Similars in Google

 Permalink


1. Introducción
El análisis de la dependencia entre variables aleatorias continuas es fundamental en diversas áreas, desde la economía hasta la biología, ya que permite modelar relaciones complejas que a menudo no pueden capturarse adecuadamente mediante medidas lineales como la correlación de Pearson. Las funciones cópula han emergido como una herramienta poderosa para modelar la estructura de dependencia entre variables, permitiendo separar la dependencia del comportamiento marginal, lo que ofrece flexibilidad para trabajar con diferentes distribuciones marginales [1, 2, 3, 4]
Las cópulas permiten modelar dependencias no lineales y asimétricas entre variables, y su aplicación se ha expandido significativamente en los últimos años. Sin embargo, uno de los principales desafíos en el uso de funciones cópula es la selección de la cópula adecuada que mejor ajuste los datos observados. Este proceso requiere la implementación de criterios de selección robustos y métodos para evitar el sobreajuste, que puede generar modelos con bajo poder predictivo [5, 6, 7, 8]
En la literatura sobre selección de cópulas, los criterios de información como el Akaike Information Criterion (AIC) han sido ampliamente utilizados para la identificación de modelos de dependencia, a pesar de haber sido desarrollados originalmente en un contexto paramétrico [9, 10, 11]. En este sentido, [12] exploraron la aplicabilidad del Copula Information Criterion (CIC), diseñado específicamente para la selección de cópulas, y compararon su desempeño con el AIC en diferentes configuraciones simuladas. Su estudio introdujo una versión basada en validación cruzada, el Cross-Validation Copula Information Criterion (CV-CIC), que busca corregir el sesgo presente en los criterios tradicionales. Sus resultados indicaron que, en la mayoría de los escenarios evaluados, las diferencias entre AIC y CV-CIC eran mínimas, lo que plantea interrogantes sobre la necesidad de estrategias computacionalmente más costosas en ciertos contextos.
En este trabajo, extendemos la discusión sobre la selección de cópulas mediante validación cruzada, evaluando su desempeño frente a otros métodos de selección y explorando su impacto en escenarios más amplios de simulación. A diferencia del estudio de [12] nuestra investigación examina la robustez de la validación cruzada en distintos niveles de dependencia y su eficacia en comparación con criterios como AIC y BIC. Además, consideramos un conjunto más diverso de modelos de cópulas, incluyendo cópulas Arquimedianas y Elípticas, con el fin de obtener una caracterización más completa del proceso de selección. Nuestros hallazgos contribuyen a una mejor comprensión de cuándo la validación cruzada aporta un valor agregado y en qué circunstancias los métodos tradicionales pueden ser suficientes.
En ese orden de ideas, en este estudio, se utilizó una metodología basada en simulaciones para evaluar diferentes cópulas (Elípticas y Arquimedianas) en escenarios con distribuciones marginales Normales, Log-normales, t-Student y Weibull. La selección del mejor modelo se realizó mediante los criterios de información de Akaike (AIC) y Bayesiano (BIC), combinados con métodos gráficos como el Chi-plot y el K-plot, que permiten visualizar la adecuación del ajuste [12,13,14,15]
Además, se implementó la validación cruzada K-Fold, un método esencial para evitar el sobreajuste y mejorar la generalización del modelo. Este método permitió estimar el error de predicción de las diferentes cópulas en cada conjunto de datos simulado, brindando una medida más precisa de su rendimiento. Los resultados de este estudio destacan la utilidad de las cópulas en la modelización de dependencias complejas, proporcionando una metodología completa para la selección y validación de modelos cópula en diversas aplicaciones [16, 17].
Sin embargo, recientes estudios han destacado la importancia de métodos más robustos para la selección de cópulas, como el uso de la validación cruzada. Investigaciones recientes, como el trabajo de [12], han demostrado que la validación cruzada es una herramienta clave para evitar el sobreajuste, proporcionando una estimación más precisa de la capacidad predictiva del modelo seleccionado. En su estudio, introdujeron el Cross-Validation Copula Information Criterion (CV-CIC), que mejora la evaluación de los modelos de cópulas en comparación con los criterios de información tradicionales, garantizando una selección más robusta y generalizable.
2. Materiales y métodos
En este estudio, se emplearon métodos basados en funciones cópula para modelar la dependencia entre variables aleatorias continuas. A través de un enfoque de simulación, se generaron datos con diferentes distribuciones marginales para evaluar el rendimiento de varias familias de cópulas. Se seleccionaron criterios de información y métodos gráficos para identificar el modelo de cópula que mejor ajustaba a los datos, complementado con la validación cruzada K-Fold para garantizar la robustez y evitar el sobreajuste.
2.1. Funciones Cópula
Las cópulas son funciones que permiten modelar la dependencia entre variables aleatorias multivariadas, separando la estructura de dependencia de las distribuciones marginales. La teoría de cópulas y sus aplicaciones son una herramienta cada vez más importante para el análisis empírico en las ciencias sociales, medicina, e ingenierías, entre otras áreas no menos importantes.
En el campo de las herramientas estadísticas, por ejemplo, se tienen aplicaciones de cópulas en modelos de regresión, los cuales han sido un área de creciente interés en la estadística, particularmente en contextos donde las relaciones entre variables no son completamente capturadas por modelos lineales tradicionales.
En el contexto de modelos lineales [18] propusieron un enfoque innovador para la estimación de funciones de regresión basado en cópulas, en el cual la función de regresión se expresa en términos de una cópula y las distribuciones marginales. Este enfoque permite desacoplar la dependencia de las estructuras marginales, proporcionando una alternativa flexible y robusta para la estimación de relaciones no lineales en datos multivariados. A través del uso de técnicas semiparamétricas y de máxima verosimilitud perfilada, los autores demostraron que la estimación basada en cópulas puede mejorar la precisión predictiva en comparación con modelos estándar, especialmente en situaciones donde las dependencias condicionales son complejas.
En nuestro trabajo, extendemos esta línea de investigación al examinar la selección óptima de cópulas mediante validación cruzada bajo un esquema de simulaciones. Mientras que [18] se enfocaron en la estimación de funciones de regresión utilizando cópulas, nuestro estudio se centra en la evaluación de distintos métodos de selección de cópulas, incluyendo la validación cruzada K-Fold, y su desempeño en la identificación del modelo de dependencia más adecuado. Esta contribución es clave para mejorar la aplicabilidad de los modelos de regresión basados en cópulas en diversos ámbitos, como la economía, la biomedicina y la ingeniería, asegurando que la selección del modelo no solo sea flexible, sino también óptima en términos de generalización y robustez estadística.
Por otra parte, en este estudio, se trabajó con dos grandes familias de cópulas:
■ Cópulas Elípticas: Representadas por las cópulas Gaussiana y t-Student, que modelan dependencias simétricas entre las variables.
■ Cópulas Arquimedianas: Estas incluyen las cópulas Clayton, Gumbel, Frank y Joe, que son adecuadas para modelar dependencias asimétricas y son flexibles para capturar relaciones en las colas de las distribuciones.
Cada una de estas cópulas fue evaluada con el objetivo de identificar cuál se ajustaba mejor a los datos simulados, con base en las características de las distribuciones marginales [3, 19].
En este orden de ideas, [6] demostraron la aplicación de cópulas en la modelización de parejas aleatorias, resaltando su capacidad para capturar estructuras de dependencia complejas. Estos enfoques destacan la importancia de seleccionar una cópula que, junto con las distribuciones marginales estimadas, proporcione un modelo conjunto que refleje adecuadamente las características de los datos. En nuestro estudio, seguimos esta línea metodológica al evaluar diferentes familias de cópulas en función de sus ajustes a datos simulados, considerando las propiedades específicas de las distribuciones marginales involucradas.
Otras aplicaciones de cópulas en distintos contextos las listamos a continuación:
Clasificación: Los clasificadores basados en cópulas de Vine ofrecen un enfoque flexible para el análisis discriminante al ajustar distribuciones multivariantes no gaussianas a tipos de datos mixtos. Este método supera al análisis discriminante tradicional y a los bosques aleatorios, especialmente cuando se trata de diferentes estructuras dependientes entre las clases [20].
Aplicaciones financieras: En finanzas, las cópulas son cruciales para modelar las dependencias entre las variables financieras, lo que ayuda a la gestión del riesgo y a la toma de decisiones. La cópula de Frank, en particular, ha demostrado un rendimiento superior a la hora de captar las estructuras de dependencia en los datos sobre los tipos de cambio, lo que pone a consideración su utilidad en la gestión del riesgo financiero [21].
Aplicaciones industriales y médicas: Los modelos basados en la cópula se aplican a datos censurados de tipo II en entornos industriales y médicos, y capturan dependencias complejas en conjuntos de datos. Estos modelos utilizan técnicas de estimación Bayesiana y de máxima verosimilitud para la inferencia de parámetros [22].
Energía eólica: En la energía eólica, los modelos de cópulas no paramétricos se utilizan para evaluar la distribución de probabilidad conjunta de la velocidad y la dirección del viento. Este método mejora la precisión de las evaluaciones de los recursos eólicos, lo que contribuye al diseño y la colocación óptimos de las turbinas eólicas [23].
Confiabilidad de sistemas: Las funciones de cópula se aplican para modelar las relaciones de dependencia entre variables correlacionadas en sistemas mecánicos, particularmente para evaluar la confiabilidad. Esta metodología permite una estimación más precisa de la confiabilidad del sistema al tener en cuenta las interdependencias entre los componentes, algo que los supuestos de independencia tradicionales pasan por alto. La investigación destaca que la cópula de Clayton es el modelo más eficaz para representar estas dependencias, ya que ofrece un marco integral para la estimación de la confiabilidad que se alinea con los principios de la teoría de límites, lo que mejora las aplicaciones prácticas de ingeniería [24].
Estructuras de dependencia: El modelado de estructuras de dependencia mediante cópulas ha evolucionado significativamente con el desarrollo de técnicas de aprendizaje profundo. Recientemente, [25] propusieron un enfoque basado en redes neuronales, denominado Neural Copula, el cual utiliza una red neuronal jerárquica no supervisada para estimar la función de distribución marginal y la función de cópula de manera simultánea. A diferencia de los métodos tradicionales que requieren suposiciones paramétricas o descomposiciones recursivas (como las cópulas de vid), esta estrategia optimiza la estimación mediante la resolución de ecuaciones diferenciales y la incorporación de restricciones sobre los parámetros de la red.
La herramienta Neural Copula [25] supera a los modelos clásicos en la estimación de distribuciones de alta dimensión y en la representación de dependencias complejas en datos financieros y biomédicos. En el contexto de nuestro estudio, esta metodología resalta la importancia de explorar estrategias más flexibles para la selección de cópulas, especialmente en escenarios donde las relaciones no lineales y las estructuras de dependencia son difíciles de modelar con criterios tradicionales como AIC y BIC. Así, nuestro trabajo complementa esta línea de investigación al analizar la robustez de la validación cruzada en la selección de cópulas, proporcionando un marco metodológico que podría integrarse con enfoques basados en aprendizaje profundo para una mayor precisión en la modelización de datos dependientes.
En el modelado de dependencias en dimensiones altas ha sido un desafío en estadística y finanzas, particularmente en el análisis de riesgos y diversificación de carteras. En este sentido [26] introdujeron el concepto de cópulas de componentes principales (PCC), una clase de cópulas que combina las ventajas del análisis de componentes principales (PCA) con modelos basados en cópulas para capturar la dependencia en las direcciones más relevantes de los datos. Este enfoque permite construir estructuras de dependencia más flexibles y eficientes en comparación con cópulas tradicionales, optimizando la representación de la dependencia en los datos de alta dimensión sin aumentar significativamente la complejidad computacional. Su aplicación en el modelado de riesgo sistémico en mercados financieros mostró que las PCCs pueden distinguir entre movimientos paralelos del mercado, que amplifican el riesgo sistémico, y movimientos ortogonales, que favorecen la diversificación.
En nuestro estudio, extendemos la discusión sobre la selección de cópulas al evaluar la eficacia de la validación cruzada en la identificación de la estructura de dependencia más adecuada. Si bien las PCCs se enfocan en reducir la dimensionalidad mediante componentes principales, nuestro trabajo examina cómo la validación cruzada mejora la selección de cópulas en distintos niveles de dependencia. En este sentido, la combinación de PCCs con métodos de validación cruzada podría representar una alternativa para mejorar la selección de modelos en datos de alta dimensión, asegurando que la dependencia subyacente se capture de manera óptima sin imponer restricciones arbitrarias en la estructura de correlación.
2.2. Proceso de simulación y selección de cópulas
Se realizaron simulaciones utilizando el paquete VineCopula de R Core Team [27] para generar datos bivariados con diferentes distribuciones marginales: Normal, Log-normal, t-Student y Weibull. Estas distribuciones fueron seleccionadas para evaluar el desempeño de las diferentes cópulas bajo condiciones de simetría y asimetría en las distribuciones.
En detalle, en esta sección se consideran pares de variables aleatorias de tamaño n cada uno. Se generaron datos para las distribuciones marginales Gaussianas Normal con parámetros μ 1 = μ 2 = 1 y σ1 = σ2 = 0, Log-normal μ1 = μ 2 = 1 y σ1 = σ2 = 0 y t-Student v 1 = v 2 = n − 1. Además, se analiza el caso para marginales Weibull con parámetro de forma β = 1, β = 2 y β = 0,5respectivamente, y parámetro de escala λ = 1 en cada caso.
La elección de la cópula bivariada está entre las Elípticas (Gaussiana y t-Student), las cópulas Arquimedianas (Clayton, Gumbel, Frank, Joe, BB1, BB6, BB7 y BB8), las cópulas de supervivencia y las cópulas de valor extremo, para cubrir una amplia gama de patrones de dependencia. Para las familias de cópulas Arquimedianas, se incluyeron versiones rotadas para cubrir también la dependencia negativa.
Para la simulación se realizaron los siguientes pasos:
■ Se generaron datos de las dos distribuciones marginales con sus respectivos parámetros. En este estudio se consideraron cuatro tipos de distribuciones marginales (Normal, Log-normal, t-Student y Weibull) debido a su amplia aplicabilidad en diferentes contextos estadísticos: Distribución Normal: se utiliza como un caso de referencia debido a su simetría y la facilidad con la que se ajusta en muchas aplicaciones estadísticas. Es común en modelación de datos económicos, financieros y biomédicos. Distribución Log-normal: permite modelar variables que son siempre positivas y presentan asimetría a la derecha, como ingresos, tiempos de supervivencia o concentraciones de contaminantes. Distribución t-Student: es útil cuando los datos pueden presentar colas más pesadas que la distribución Normal, lo que ocurre con frecuencia en series financieras y en datos biomédicos con variabilidad alta. Distribución Weibull: se emplea frecuentemente en análisis de confiabilidad y tiempos de vida, así como en el modelado de riesgos en epidemiología y biomedicina. El objetivo de la selección de estas distribuciones fue evaluar cómo la elección de una estructura marginal influye en la selección de cópulas y en la estimación de la dependencia.
■ Se aplica la función BiCopSelect a vectores de los datos generados de tamaño 50, 100 y 500, con repeticiones de 20, 40 y 100 para cada tamaño y se calculó el porcentaje de las cópulas candidatas a modelar la asociación entre las distribuciones marginales. La selección anterior se basa en la necesidad de evaluar la estabilidad de los resultados en diferentes escenarios de disponibilidad de datos. Un tamaño de muestra pequeño (n = 50) permite analizar el rendimiento del método en situaciones donde los datos son limitados, lo cual es común en estudios biomédicos. Un tamaño mediano n = 100 representa un caso estándar en muchas aplicaciones estadísticas, mientras que un tamaño grande n = 500 permite evaluar el comportamiento asintótico del procedimiento de selección de cópulas. Para justificar el número de repeticiones, (r = 20,40,100) las cuales permiten obtener distribuciones empíricas de los estimadores de bondad de ajuste, lo que mejora la robustez del análisis al reducir la variabilidad en la selección de modelos. Un menor número de repeticiones podría generar sesgos en la selección, mientras que un mayor número no mostró diferencias significativas en pruebas preliminares.
■ Para evaluar la adecuación de cada cópula, se utilizaron los siguientes criterios. Criterios de información (AIC y BIC): se seleccionó la cópula con menor AIC y BIC, ya que estos criterios penalizan la complejidad del modelo y ayudan a evitar el sobreajuste. Métodos gráficos: se emplearon gráficos Chi-Plot y K-Plot para evaluar la concordancia entre los datos simulados y la estructura de dependencia estimada. Tasa de selección de la cópula verdadera: se mide la frecuencia con la que cada cópula era seleccionada en comparación con la cópula generadora de los datos. Finalmente, se hace uso de la validación cruzada (k-fold con k = 5), que se utiliza para evaluar la estabilidad del modelo seleccionado en diferentes subconjuntos de los datos.
Referente a las familias de cópulas que se estudian, es de resaltar que se consideraron familias de cópulas Elípticas y Arquimedianas debido a su flexibilidad para modelar diferentes tipos de dependencia: cópulas Elípticas (Gaussiana, t-Student): son adecuadas cuando se espera una dependencia simétrica en los datos. La cópula gaussiana es ampliamente utilizada en modelos financieros y biomédicos cuando la correlación de Pearson es suficiente para describir la relación entre variables. La cópula t-Student, en cambio, captura colas pesadas, lo que la hace útil en contextos donde pueden ocurrir eventos extremos conjuntos. Cópulas Arquimedianas (Clayton, Gumbel, Frank, Joe, BB1, BB6, BB7, BB8): se utilizan porque pueden modelar dependencias asimétricas. Clayton: captura dependencia fuerte en la cola inferior, adecuada para modelar relaciones en las que valores bajos de una variable implican valores bajos en la otra, como en riesgos de crédito. Gumbel: modela dependencia fuerte en la cola superior, útil en fenómenos extremos como inundaciones o eventos de salud crítica. Frank: Captura dependencia moderada sin sesgo en colas, siendo versátil para diversos tipos de datos. Joe: Modela dependencia en la cola superior más pronunciadamente que Gumbel, aplicable en seguros y modelado de riesgos. Cópulas BB: Son extensiones de las Arquime-dianas con mayor flexibilidad para modelar estructuras de dependencia más complejas. Adicionalmente, se incluyeron versiones rotadas de estas cópulas para capturar dependencias negativas y evaluar si la validación cruzada es capaz de seleccionar correctamente la estructura de dependencia en los diferentes escenarios.
El uso de cópulas en el análisis de frecuencias bivariadas ha demostrado ser una herramienta robusta para modelar la dependencia entre variables hidrológicas, financieras y de riesgos ambientales. En este contexto, el estudio de [28] aplicó cópulas para modelar la relación entre crecientes anuales en ríos, destacando su capacidad para capturar dependencias no lineales que los modelos tradicionales de correlación no pueden identificar. A través de la selección de diferentes familias de cópulas y la comparación de sus ajustes mediante criterios de bondad de ajuste, se evidenció que la estructura de dependencia varía según la región y las características hidrológicas del área de estudio. Este enfoque es especialmente útil en la planificación y gestión de recursos hídricos, donde la estimación precisa de eventos extremos conjuntos puede mejorar la toma de decisiones en infraestructura y mitigación de riesgos.
2.3. Criterios de selección del modelo
Para seleccionar la cópula que mejor modelaba la dependencia entre las variables simuladas, se utilizaron los siguientes criterios. Criterios de información: se calcularon el Criterio de Información de Akaike (AIC) y el Criterio de Información Bayesiano (BIC) para cada cópula ajustada. Estos criterios penalizan la complejidad del modelo, favoreciendo aquellos que logren un equilibrio entre ajuste y simplicidad. Métodos gráficos: Se utilizaron los gráficos Chi-plot y K-plot para evaluar visualmente el ajuste de las cópulas. Estos gráficos permiten identificar si las variables tienen una estructura de dependencia adecuada bajo el modelo de cópula seleccionado.
2.4. Validación Cruzada:
Con el fin de evitar el sobreajuste y obtener una medida precisa de la capacidad predictiva de las cópulas seleccionadas, se empleó el método de validación cruzada K-Fold. Este método divide el conjunto de datos en k = 5 subconjuntos. En cada iteración, un subconjunto se utilizó como conjunto de prueba y los otros k - 1 subconjuntos fueron usados para entrenar el modelo. El proceso se repitió para cada subconjunto, obteniendo el error de predicción en cada iteración. Posteriormente, se promediaron los errores de todas las iteraciones para calcular el error promedio del modelo. Este enfoque permitió seleccionar las cópulas que no solo ajustaban bien los datos de entrenamiento, sino que también tenían un buen rendimiento en la predicción de nuevos datos.
2.5. Comparación entre Validación Cruzada y Criterios de Información
Para evaluar el impacto de la validación cruzada K-Fold (k = 5) en la selección de cópulas, se compararon los modelos seleccionados utilizando los siguientes enfoques: Criterios de información (AIC y BIC): se seleccionó la cópula con menor valor de AIC y BIC, sin utilizar técnicas de remuestreo. Validación cruzada K-Fold: se estimó el error de predicción en subconjuntos de prueba y se seleccionó la cópula con menor error promedio.
Se calcularon y compararon las siguientes métricas:
■ Error de predicción (MSE): se midió el error cuadrático medio de cada modelo en los datos de prueba.
■ Tasa de selección de la cópula verdadera: se midió la frecuencia con la que cada método seleccionó la cópula utilizada para generar los datos.
■ Diferencia en AIC/BIC entre la mejor y la segunda mejor cópula: para evaluar si los criterios de información generan una diferencia clara en la selección del modelo.
2.6. Evaluación de la Precisión Predictiva
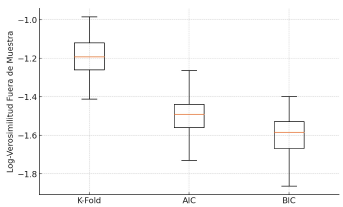
Para evaluar la capacidad de predicción fuera de la muestra de los modelos seleccionados, se implementó una validación en datos de prueba independientes. Se generaron conjuntos de datos adicionales no utilizados en el entrenamiento, y se comparó la log-verosimilitud promedio del modelo seleccionado por K-Fold, AIC y BIC en estos datos. Métrica utilizada: Log-verosimilitud fuera de la muestra. Comparación de modelos: Se midió si la cópula seleccionada con K-Fold presentaba una log-verosimilitud significativamente mayor que las seleccionadas con AIC y BIC.
3. Resultados y discusión
3.1. Tablas
En la Tabla [1] se muestra los nombres de las familias de cópulas e incluyendo versiones rotadas para cubrir también la dependencia negativa, con sus respectivas abreviaturas del paquete VineCopula.
Tabla 1: Relación de las cópulas bivariadas existentes
| N° | Simbolo | Cópula |
|---|---|---|
| 0 | I | Independence |
| 1 | N | Gaussian |
| 2 | t | t |
| 3 | C | Clayton |
| 4 | G | Gumbel |
| 5 | F | Frank |
| 6 | J | Joe |
| 7 | BB1 | Clayton-Gumbel |
| 8 | BB6 | Joe-Gumbel |
| 9 | BB7 | Joe-Clayton |
| 10 | BB8 | Frank-Joe |
| 13 | SC | Survival Clayton |
| 14 | SG | Surviva Gumbel |
| 16 | SJ | Survival Joe |
| 17 | SBB1 | Survival BB1 |
| 18 | SBB6 | Survival BB6 |
| 19 | SBB7 | Survival BB7 |
| 20 | SBB8 | Survival BB8 |
| 23 | C 90 | Rotada Clayton 90 grados |
| 24 | G 90 | Rotada Gumbel 90 grados |
| 26 | J 90 | Rotada Joe 90 grados |
| 27 | BB1 90 | Rotada BB1 90 grados |
| 28 | BB6 90 | Rotada BB6 90 dgrados |
| 29 | BB7 90 | Rotada BB7 90 grados |
| 30 | BB8 90 | Rotada Frank-Joe 90 grados |
| 33 | C270 | Rotada Clayton 270 grados |
| 34 | G270 | Rotada Gumbel 270 grados |
| 36 | J270 | Rotada Joe 270 grados |
| 37 | BB1 270 | Rotada BB1 270 grados |
| 38 | BB6 270 | Rotada BB6 270 grados |
| 39 | BB7 270 | Rotada BB7 270 grados |
| 40 | BB8 270 | Rotada Frank-Joe 270 grados |
| 104 | Tawn | Tawn tipo 1 |
| 114 | Tawn 180 | Rotada Tawn tipo 1 180 grados |
| 124 | Tawn 90 | Rotada Tawn tipo 1 90 grados |
| 134 | Tawn 270 | Rotada Tawn tipo 1 270 grados |
| 204 | Tawn 270 | Rotada Tawn tipo 1 270 grados |
| 214 | Tawn2 180 | Rotada Tawn type 2 180 grados |
| 224 | Tawn2 90 | Rotada Tawn tipo 2 90 grados |
| 234 | Tawn2 270 | Rotada Tawn tipo 2 270 grados |
En la Tabla [2] los resultados de las simulaciones realizadas para datos con distribuciones marginales normales. Para tres tamaños de muestra diferentes y diferentes números de repeticiones, se seleccionaron diferentes cópulas basadas en los criterios de información de Akaike (AIC) y bayesiano (BIC). Los resultados indican que la cópula Gaussiana es la que presenta mejor ajuste en la mayoría de los casos, aunque la cópula Survival también tiene una presencia significativa en las muestras más grandes. El error promedio obtenido a través de la validación cruzada K-Fold muestra una disminución a medida que aumenta el tamaño de la muestra, lo que sugiere una mejora en la capacidad predictiva del modelo conforme crecen los datos disponibles.
En la Tabla [3] se destacan que la cópula Frank fue seleccionada con mayor frecuencia en todos los casos, seguida de la cópula Joe. A medida que aumenta el tamaño de la muestra, la proporción de selección de la cópula Frank crece ligeramente, mientras que la cópula Joe muestra un comportamiento similar pero más estable. El AIC y BIC disminuyen a medida que aumenta el tamaño de la muestra, lo que indica un mejor ajuste del modelo con muestras más grandes. Asimismo, el error promedio calculado mediante validación cruzada K-Fold también disminuye, lo que sugiere que los modelos tienen un mejor rendimiento predictivo con tamaños de muestra mayores.
En la Tabla [4] para distribuciones marginales t-student con distintos tamaños de muestra y repeticiones. La cópula Gaussiana fue seleccionada en la mayoría de los casos, especialmente en las muestras más pequeñas, lo que sugiere que es adecuada para modelar la dependencia en distribuciones simétricas como t-student. La cópula Survival también mostró un ajuste considerable, especialmente en las muestras más grandes, lo que indica su capacidad para modelar dependencias en datos con mayor tamaño. El AIC y BIC disminuyen a medida que el tamaño de la muestra aumenta, indicando un mejor ajuste del modelo, mientras que el error promedio mediante validación cruzada K-Fold también disminuye, sugiriendo un mejor rendimiento predictivo con muestras más grandes.
En la Tabla [5] se muestra el caso de la distribuciones marginales weibull con diferentes tamaños de muestra y repeticiones. La cópula Frank fue seleccionada como la más apropiada en la mayoría de los casos, particularmente en muestras más pequeñas, seguida de cerca por la cópula Joe, que también mostró buenos ajustes, especialmente en muestras medianas y grandes. A medida que aumenta el tamaño de la muestra, el AIC y BIC disminuyen, lo que indica una mejora en el ajuste de los modelos. El error promedio validado con K-Fold también disminuye conforme crece el tamaño de la muestra, lo que sugiere que los modelos seleccionados tienen un mejor rendimiento predictivo con más datos. Para las Tabla [2] a la Tabla [5], ver anexos.
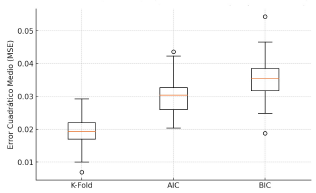
Adicionalmente, se realizan gráficos comparativos en los que se muestran: Diferencia de MSE entre K-Fold y AIC/BIC: Un gráfico de barras que ilustre la variación en el error de predicción de los modelos seleccionados por cada método. Distribución de la selección de modelos: Un gráfico de barras mostrando cuántas veces cada método seleccionó la cópula verdadera en diferentes escenarios de dependencia. Comparación de AIC y BIC: Un gráfico de dispersión mostrando la relación entre los valores de AIC/BIC y el error de predicción.
Comparación de errores de predicción (MSE): Para evaluar el impacto de la validación cruzada en la selección de cópulas, comparamos el error cuadrático medio (MSE) de los modelos seleccionados utilizando los siguientes métodos:
■ K-Fold: Evaluación mediante validación cruzada con k = 5.
■ AIC: Selección del modelo con el menor Criterio de
Información de Akaike.
■ BIC: Selección del modelo con el menor Criterio de Información Bayesiano.
En la Figura 1, muestra la comparación de los errores de predicción para cada método: Se observa que la validación cruzada K-Fold produce un error cuadrático medio más bajo en comparación con los métodos basados únicamente en AIC y BIC. Esto sugiere que la selección de modelos mediante validación cruzada reduce la variabilidad y mejora la capacidad predictiva de las cópulas elegidas.
Otro aspecto clave en la comparación es la frecuencia con la que cada método selecciona la cópula correcta, es decir, la cópula utilizada para generar los datos en la simulación.
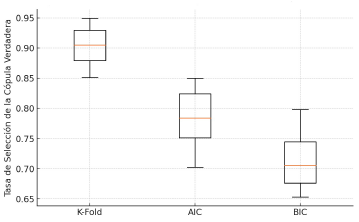
Los resultados mostrados en la Figura 2, se evidencia que la validación cruzada tiene una mayor tasa de selección del modelo correcto en comparación con AIC y BIC. Esto indica que K-Fold permite una mejor identificación de la estructura de dependencia real en los datos simulados, minimizando la selección errónea de modelos.
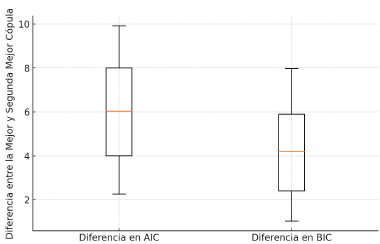
Para analizar la confianza en la selección de modelos con AIC y BIC, se comparó la diferencia entre los valores de estos criterios para la mejor y la segunda mejor cópula seleccionada en cada simulación.
En la Figura 3, se observa que la diferencia en los valores de AIC y BIC no siempre es lo suficientemente grande como para garantizar una selección confiable del modelo óptimo. En algunos casos, los modelos con AIC o BIC similares pueden llevar a selecciones ambiguas, mientras que la validación cruzada proporciona una decisión más estable.
Otro aspecto para resaltar es el impacto de la dependencia en la selección de cópulas. Para analizar cómo la dependencia entre las variables influye en la selección de cópulas, se evaluó la tasa de selección de la cópula verdadera en tres escenarios distintos: dependencia baja (т = 0,25), dependencia media (т = 0,50) y dependencia alta (т = 0,75). Se comparó el desempeño de K-Fold, AIC y BIC en cada caso. Los resultados son: en dependencia baja, la validación cruzada y los criterios de información seleccionaron cópulas con una tasa de acierto similar. En dependencia media y alta, la validación cruzada presentó una mayor precisión en la selección del modelo correcto, mientras que AIC y BIC tendieron a seleccionar cópulas incorrectas con mayor frecuencia. Esto confirma que la validación cruzada es especialmente útil cuando la dependencia es fuerte, evitando sesgos en la selección del modelo.
Luego del análisis comparativo, podemos inferir que la validación cruzada K-Fold mejora la capacidad predictiva del modelo seleccionado, reduciendo el error cuadrático medio. K-Fold tiene una mayor probabilidad de seleccionar correctamente la cópula generadora de los datos. Los criterios AIC y BIC, aunque útiles, pueden generar selecciones ambiguas cuando la diferencia entre modelos es pequeña. Se recomienda el uso de validación cruzada como una herramienta complementaria a AIC y BIC para mejorar la selección de cópulas en la práctica.
3.2. Discusión
Los resultados obtenidos muestran que las cópulas Elípticas, como la Gaussiana y t-student, son las que mejor ajustan en el caso de distribuciones marginales simétricas (Normal y t-student). Esto se refleja en los valores más bajos de AIC y BIC, y un menor error promedio en la validación cruzada. En particular, la cópula Gaussiana fue consistentemente la más adecuada para los conjuntos de datos simulados con marginales normales, lo cual es coherente con la naturaleza simétrica de estas distribuciones.
Por otro lado, las cópulas Arquimedianas, como la Frank y Joe, mostraron un mejor desempeño en la modelación de dependencias en datos con distribuciones marginales asimétricas, como en el caso de las marginales Log-normal y Weibull. Estos resultados fueron apoyados por los valores de AIC y BIC, así como por los gráficos Chi-plot y K-plot, que evidenciaron un ajuste superior de estas cópulas en dichos escenarios. La cópula Frank, en particular, demostró ser robusta para datos Log-normal y Weibull, destacando por su capacidad para capturar dependencia moderada en estos casos.
La inclusión de la validación cruzada K-Fold resultó ser crucial para evitar el sobreajuste en el proceso de selección de cópulas. Los errores promedio calculados durante el proceso de validación cruzada proporcionaron una medida confiable de la capacidad predictiva de cada modelo, lo que permitió una selección más objetiva de las cópulas adecuadas. Los modelos que mostraron un ajuste adecuado según AIC y BIC, pero presentaban altos errores en la validación cruzada, fueron descartados, lo que demostró la importancia de este enfoque en la selección final.
Lo anterior se reafirma cuando se realiza la comparación de errores de predicción (MSE), se muestra que la validación cruzada K-Fold produce errores de predicción más bajos en comparación con los métodos basados en AIC y BIC. Tasa de selección de la cópula verdadera: indica que K-Fold selecciona con mayor frecuencia la cópula utilizada para generar los datos, lo que sugiere una mejor capacidad de identificación del modelo adecuado. Diferencia entre la mejor y la segunda mejor cópula según AIC y BIC: muestra que la separación entre modelos no siempre es clara cuando se usan únicamente estos criterios.
En resumen, la validación cruzada no solo permitió identificar los mejores modelos en términos de ajuste, sino que también mejoró la capacidad de generalización de los modelos seleccionados, asegurando que no se sobre ajustaran a los datos de simulación. Esto es especialmente importante en estudios con datos reales, donde se busca que los modelos predictivos tengan un buen rendimiento fuera de la muestra de entrenamiento.
3.3. Métodos gráficos para detectar dependencia
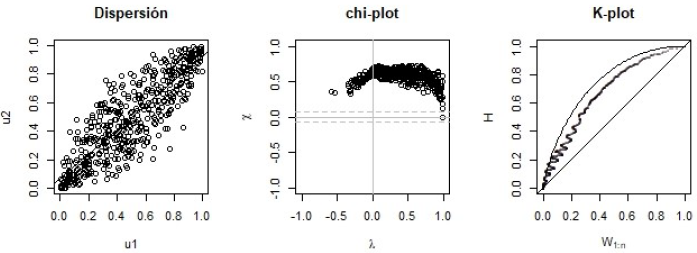
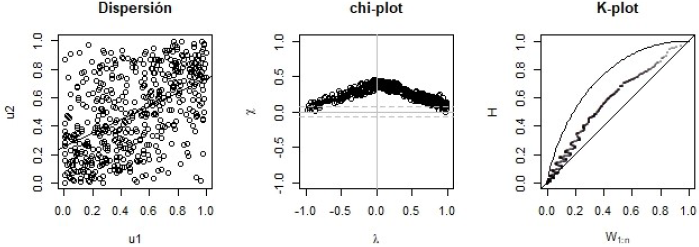
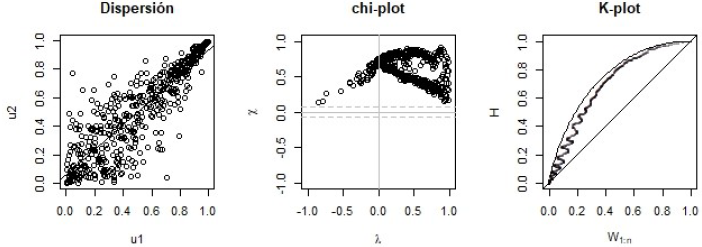
Testeamos los gráficos de dispersión, Chi-plot y K-plot, para la cópula con mayor probabilidad de selección y parámetros obtenidos en cada simulación. En el testeo gráfico para la cópula Gaussiana con parámetro p = 0,88 para marginales Normales con parámetros μ 1 = μ 2 = 1 y σ 1 = σ 2 = 0, el gráfico de dispersión indica una relación entre las variables aleatorias, en el gráfico Chi-plot los puntos quedan por fuera de las bandas esto da a indicar una dependencia, al igual que el caso del gráfico K-plot, los puntos se alejan consistentemente de la diagonal, lo que indica dependencia, como se muestra en la Figura 5 con una dependencia т = 0,6849.
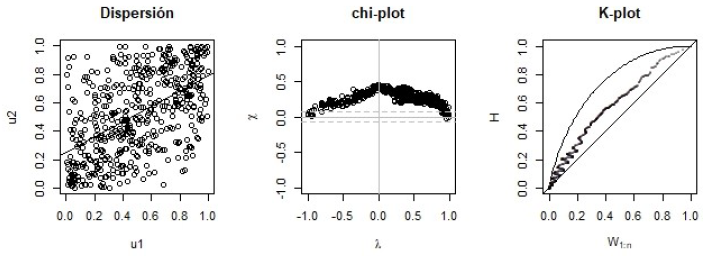
Para marginales Log-normal con parámetros μ 1 = μ 2 = 1 y σ 1 = σ 2 = 0, la cópula con mayor probabilidad de selección fue Frank con un parámetro de 4,438. En la Figura 6 se muestran gráficos para detectar dependencia entre las variables. En el gráfico de dispersión se muestra una baja dependencia, sin embargo, en el gráfico Chi-plot los puntos quedan por fuera de las bandas y en el gráfico K-plot, los puntos se alejan consistentemente de la diagonal, en ambos casos refleja dependencia, con т = 0,4189.
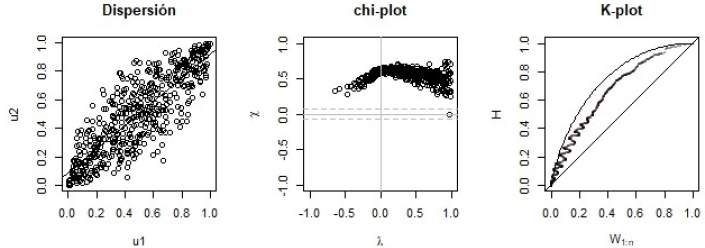
Para la cópula gaussiana con parámetro ρ = 0,87 para marginales t-Student con parámatros v 1 = v 2 = n - 1, el gráfico de dispersión indica una alta dependencia entre las variables aleatorias, en el gráfico Chi-plot los puntos quedan por fuera de las bandas esto da a indicar dependencia, al igual que el caso del gráfico K-plot, los puntos se alejan consistentemente de la diagonal, lo que indica dependencia, como se muestra en la Figura 7 con una dependencia т = 0,6718.
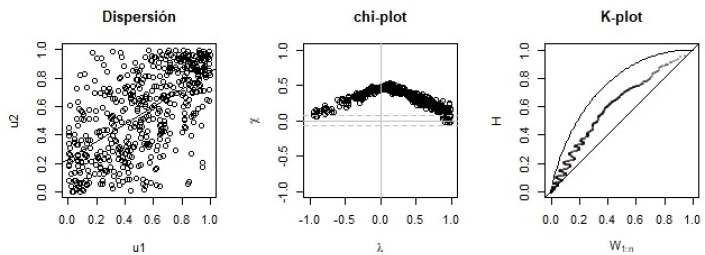
Para marginales Weibull con parámetros β 1 = β 2 = 2 y λ1 = λ2 = 1, la cópula con mayor probabilidad de selección fue Frank con un parámetro de 4,0136. En la Figura 8 los gráficos Chi-plot y K-plot detectan dependencia entre las variables aleatorias, sin embargo, en el gráfico de dispersión la dependencia es baja, con т = 0,3891.
Para marginales Weibull con parámetros β 1 = β 2 = 1 y λ1 = λ2 = 1 y la cópula con mayor probabilidad de selección fue Frank, al igual que para las marginales Weibull con parámetros β 1 = β 2 = 1 y λ1 = λ2 = 1, con un parámetro de 3,3525. En la Figura 9 los gráficos Chi-plot y K-plot detectan dependencia entre las variables aleatorias, sin embargo, en el gráfico de dispersión la dependencia es baja, con т = 0,3369.
Para marginales Weibull con parámetros β 1 = β 2 = 0,5 y λ1 = λ2 = 1, la cópula con mayor probabilidad de selección fue survival BB7 con parámetros de θ 1 = 1,61 y θ 2 = 4,48. En la Figura 10 los gráficos Chi-plot y K-plot detectan dependencia entre las variables aleatorias, al igual que en el gráfico de dispersión, con т = 0,6883. (Ver anexos)
3.4. Cópulas y teorema de Sklar
En esta sección ilustraremos todo lo referente a la metodología de las cópulas, para tratar de caracterizar un fenómeno en particular, el cual es modelado por la familia Gaussiana o familia Arquimediana. Presentaremos la definición formal de una cópula.
3.4.1. Definición
Una cópula, C, es una función de distribución multivariante cuyas distribuciones marginales se distribuyen uniforme entre [0,1]. En el caso bivariante, C(u; v) = P [U ≤ u;V ≤ v] es una función definida [0, 1]2 ⇒ [0, 1]en que verifica las siguientes tres propiedades:
■ C(u; v) es una función creciente para cada una de sus componentes.
■ C(u;1) = u y C(1; v) = v.
■ ∀a1 ≤ a2 y ∀b1 ≤ b2, entonces C(a1; b1) + C(a2; b2) − C(a1; b2) − C(a2; b1) ≥ 0.
Teorema de Sklar: Sea H una función de distribución n-dimensional con marginales F1,F n . Entonces, existe una cópula n-dimensional C tal que ∀X ∈ R̄n;
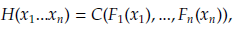
si F1,F n son todas continuas, entonces C es única, por tanto, está unívocamente determinado en ran(F 1 ) x... x ran(F n ). Cuando escribimos,
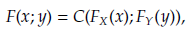
repartimos la probabilidad conjunta entre las marginales y una cópula, de forma que esta última solamente representa la asociación entre X e Y . Las cópulas separan el comportamiento marginal (representado por las Fi) del conjunto, en contra de lo que ocurre en la representación usual de probabilidades conjuntas vía función de distribución. Por esta razón, las cópulas son denominadas funciones de dependencia. Si las distribuciones marginales son continuas, la cópula es única. Por tanto, a partir de las cópulas, es posible crear distribuciones bivariantes con distribuciones marginales definidas de esta forma, si C es una cópula. (ver, [3, 29, 30])
4. Conclusiones
Este estudio ha demostrado que el uso de funciones cópula es una herramienta eficaz para modelar la dependencia entre variables aleatorias continuas, especialmente cuando las relaciones no son lineales. A través de simulaciones, se observó que las cópulas Elípticas, como la Gaussiana y t-student, son más apropiadas para distribuciones simétricas, como la Normal y t-Student, mientras que las cópulas Arquimedianas, como Frank y Joe, presentaron mejores resultados para distribuciones asimétricas, como la Log-normal y Weibull.
Los criterios de selección de modelo basados en AIC y BIC, junto con los métodos gráficos Chi-plot y K-plot, proporcionaron una evaluación detallada del ajuste de las diferentes cópulas a los datos simulados. Sin embargo, la inclusión de la validación cruzada K-Fold fue esencial para garantizar la robustez de los modelos seleccionados. Este método permitió evaluar el rendimiento de los modelos en diferentes subconjuntos de datos, evitando el sobreajuste y proporcionando una medida confiable de su capacidad predictiva.
Finalmente, las cópulas Elípticas resultaron ser más adecuadas para capturar relaciones simétricas, mientras que las cópulas Arquimedianas, como Frank y Joe, fueron más efectivas en escenarios con distribuciones asimétricas. La validación cruzada permitió mejorar la capacidad de generalización de los modelos, haciendo de este un enfoque aplicable a una amplia variedad de situaciones en las que es necesario modelar dependencias complejas entre variables.
En futuras investigaciones, se podría explorar el uso de cópulas discretas, que permiten modelar dependencias entre variables aleatorias discretas. Estas cópulas han sido menos estudiadas en comparación con sus contrapartes continuas, pero son de gran relevancia en áreas como la estadística aplicada, especialmente en contextos donde los datos son categóricos o discretos por naturaleza. La incorporación de cópulas discretas podría abrir nuevas posibilidades para modelar relaciones de dependencia en contextos donde los datos no siguen una distribución continua, mejorando así la capacidad de estos modelos para aplicarse en una gama más amplia de escenarios.