


 Spanish (pdf)
 Article in xml format
 Article references

 Automatic translation
 Send this article by e-mail
 Cited by SciELO
 Cited by Google
 Similars in
SciELO
 Similars in Google

 Permalink

Introducción
Uno de los principales problemas que enfrentan los radares modernos es la discriminación de la señal de clutter causada por el rebote de la emisión sobre la superficie que rodea al blanco. El clutteres una señal aleatoria que adquiere ocasionalmente magnitudes elevadas (spikes) que pueden confundirse con blancos (Ward, Tough, & Watts, 2013).
El procesamiento de este tipo de señal de distorsión se hace con detectores del tipo CFAR (Constant False Alarm Rate, Razón de Falsas Alarmas Constante) de ventana deslizante, que procesan la amplitud recibida. Entre ellos, el más conocido es el CA-CFAR (CellAveraging-CFAR, CFAR de Promediación de Celdas) que funciona decidiendo sobre la presencia de un blanco mediante la comparación con la magnitud de las celdas vecinas (Machado Fernández & Sánchez Rams, 2016).
Para poder establecer un umbral de detección apropiado, los detectores o procesadores CFAR necesitan generalmente del conocimiento a priori de la estadística del clutter o fondo. La aproximación tradicional a este problema consiste en asumir que el fondo sigue una distribución estadística, cuyos parámetros deben ser estimados.
Las distribuciones K (Meng, Feng, Xue, & He, 2013), Weibull (Ishii, Sayama, & Mizutani, 2011), Log-Normal (Sayama & Ishii, 2013), Rayleigh (Ishii et al., 2011) y Pareto (Weinberg, 2014) son las más utilizadas en la modelación o representación del clutter (Machado Fernández, 2017). Existen numerosos desarrollos de soluciones basadas en estas distribuciones que han enriquecido la teoría de la detección y contribuido a la mejoría de las arquitecturas de procesamiento (Sayama & Ishii, 2013; Schoenecker, Willett, & Bar Shalom, 2016; Weinberg, 2013).
Sin embargo, varios artículos han propuesto distribuciones novedosas que, a pesar de la evidencia que las respalda, han recibido relativamente poca atención por parte de la comunidad de radares. Entre ellas figuran las distribuciones Log-Weibull, Pearson (también conocida como Lévy) y Lomax.
La Log-Weibull compite directamente con la Log-Normal para la representación de clutter muy spiky (con máximos muy elevados) que se observa para muy bajo ángulo rasante y polarización HH fundamentalmente. La distribución de Pearson es un modelo sencillo uniparamétrico que contiende con la distribución Rayleigh en la modelación de clutter de baja resolución. Por último, la distribución Lomax se utiliza para clutterobservado desde aeronaves donde el ángulo rasante de la medición es medio o alto, y rivaliza con el modelo Pareto.
De acuerdo a la literatura existente en la actualidad, no hay suficiente evidencia comparativa que permita decidir sobre la superioridad de las distribuciones novedosas Log-Weibu-ll, Pearson y Lomax sobre sus contrapartes. La mayoría de las comparaciones establecidas no incluyen a estas distribuciones en los análisis. Uno de los principales problemas en este sentido es la no existencia de implementaciones informáticas de los modelos novedosos. Más específicamente, la herramienta matemática MATLAB 2016, muy utilizada en estudios de clutter, no cuenta con funciones informáticas para el trabajo con estas distribuciones.
Por tanto, el autor del presente artículo se trazó como objetivo la creación de un conjunto de funciones informáticas en MATLAB para la modelación de las distribuciones Log-Weibull, Pearson y Lomax. El código que fue finalmente implementado brinda un acceso fácil a la manipulación de las funciones de densidad y distribución, a la generación de variables aleatorias, al cálculo de los momentos y a la estimación de los parámetros de las distribuciones tratadas. Adicionalmente, se elaboraron algoritmos complementarios que permitieron la validación del código mediante la comparación con gráficas dadas por terceros y mediante la interacción del propio conjunto de funciones diseñadas.
El artículo se desarrolla como sigue. La sección 1, denominada "Materiales y Métodos", introduce las definiciones matemáticas de las distribuciones abordadas y describe las funciones informáticas que fueron creadas para la simulación del comportamiento del clutter. La sección 2, bajo el nombre de "Resultados y Discusión", muestra el correcto funcionamiento del código en forma de gráficos que caracterizan a los modelos tratados, validándose conjuntamente la implementación. La próxima sección, "Valoración del Estudio", aborda las posibilidades que brinda la investigación realizada. Por último, en "Conclusiones e Investigaciones Futuras", se resumen las principales contribuciones del artículo, señalándose también las posibles continuaciones del mismo.
1. Materiales y Métodos
La presente sección está concebida para ofrecer al lector los fundamentos de la investigación. Las primeras tres sub-secciones abordan las distribuciones Log-Weibull, Pearson y Lomax en ese orden; mientras que la cuarta presenta las funciones informáticas que fueron desarrolladas para cada una de ellas.
1.1. Distribución Log-Weibull
La distribución Log-Weibull fue aplicada a la modelación de clutter marino muy spiky por primera vez en (Sekine et al., 1980), donde demostró su superioridad con respecto al modelo Log-Normal que es utilizado frecuentemente para ángulos rasantes muy bajos, polarización HH y alta resolución. La distribución Log-Weibull ha sido utilizada con éxito para realizar ajustes de datos de clutterterrestre (Shuji Sayama & S. Ishii, 2011; Sayama & Sekine, 2001) y marino (S. Sayama & S. Ishii, 2011; Sekine et al., 1980), así como para celdas que contienen fuertes reflexiones de blancos (Ishii i et al., 2011).
El éxito de la distribución Log-Weibull está en el hecho de que su función de densidad de probabilidad se posiciona entre la Weibull y la Log-Normal. La Log-Normal suele producir estimaciones superiores a las reales sobre todo en la región de la cola, mientras que la Weibull tiende a cometer errores por defecto. En cambio, la distribución Log-Weibull tiene una cola larga y flexible en su forma (Sayama & Ishii, 2013).
A pesar de su éxito aparente, el modelo Log-Weibull ha recibido poca atención por parte de la comunidad de radares sin que hayan sido ofrecidos argumentos sólidos en su contra. La totalidad de las publicaciones que aplican Log-Weibull en radar pertenecen a un grupo reducido de científicos asiáticos que defienden el uso de la distribución.
Además del modelo concebido para radares, existe otra distribución también conocida como Log-Weibull, Gumbel o de valor extremo (extreme value). Esta distribución surge de aplicar el logaritmo a una variable distribuida Weibull, mientras que la Log-Weibull utilizada en radares aparece cuando se le aplica una exponencial a una variable Weibull, de manera similar a la Log-Normal que surge de aplicar una exponencial a una variable distribuida Normal. Desafortunadamente, la variante Log-Weibull aplicada en radares está mucho menos difundida que la Gumbel. En efecto, la mayoría de las veces que se utiliza la denominación Log-Weibull en la literatura abierta se hace referencia a la variante de valor extremo (Prabhakar Murthy, Xie, & Jiang, 2004; Rinne, 2009).
El autor considera que los problemas anteriormente planteados, junto al hecho de que prácticamente ningún documento recoge la definición matemática completa de la distribución Log-Weibull de radares, han frenado los estudios concernientes a la distribución. Adicionalmente, no se encontró ninguna herramienta de software que proporcione un acceso fácil a la simulación de la distribución Log-Weibull.
La expresión de la PDF (Probability Density Function, Función de Densidad de Probabilidad) Log-Weibull es (Ishii et al., 2011):
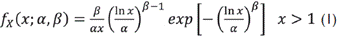
Donde c es la amplitud reflejada, α es el parámetro de escala y β es el de forma.
La CDF (Cumulative Distribution Function, Función de Distribución Acumulativa ) Log-Weibull es la siguiente (Male-vergne, Pisarenko, & Sornette, 2005):
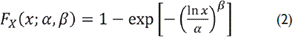
La generación de variables aleatorias Log-Weibull puede hacerse por el conocido método de inversión (Gentle, 2003):
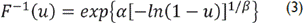
Donde u es una variable distribuida uniformemente en el intervalo [0,1] y F -1 (u) es el inverso de la función de distribución acumulativa evaluada en la magnitud de que es finalmente el valor de la muestra generada.
La distribución Log-Weibull coincide con la Weibull-Pareto cuando esta última hace su parámetro de valor mínimo igual a 1, según lo señalado por (Alzaatreh, Famoye, & Lee, 2013). Consecuentemente, los momentos algebraicos Log-Weibull pueden deducirse de aquellos de la distribución Weibull-Pareto (Alzaatreh et al., 2013):
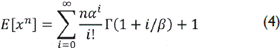
Donde Γ(. ) es la función gamma y n es el orden del momento. La función gamma se define como (O'Connor, 2011):
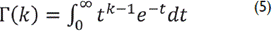
Por último, la estimación de los parámetros puede ejecutarse por el método de máxima verosimilitud, que es el comúnmente aplicado en estudios de radares. Las fórmulas a aplicar son (Zhu & Sun, 2014):
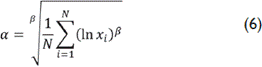
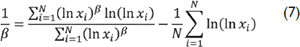
Donde x i es la muestra número i de un total de N disponibles en un conjunto.
Es importante destacar que, producto de la reducida presencia de la distribución Log-Weibull en la literatura, se encontraron algunas imprecisiones en las expresiones dadas por distintos autores. El autor corrigió estas imprecisiones y comprobó que los cambios introducidos aseguraban la correcta estimación o representación de las variables y parámetros tratados. Consecuentemente, las expresiones dadas con anterioridad pertenecen a las variantes corregidas.
1.2. Distribución Pearson
El modelo Pearson, también conocido como Lévy, ha demostrado ser apropiado para modelar datos como señales impulsivas (Nikias & Shao, 1995) y retornos de sonares activos (Pierce, 1996), en adición al clutter marino (Kuruoglu, 2003). La distribución Pearson es un caso especial de la distribución simétrica Alfa-Estable cuando el parámetro característico es α=l/2 . Si una variable sigue la distribución Pearson, su PDF es (Leung, Minett, Siu, & Lee, 2002):
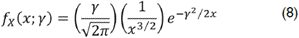
Aquí, γ es el único parámetro de la distribución, y refleja el nivel medio de la potencia del clutter. Adviértase que el modelo Pearson es de un solo parámetro (γ), cuya influencia en la escala de la distribución puede ser cancelada por los métodos CFAR tradicionales. En efecto, se probó que varios procesadores clásicos de radar mantienen la propiedad CFAR bajo clutter homogéneo distribuido Pearson en (Pierce, 1997; Tsakalide, Trinci, & Nikias, 2000), y varias expresiones han sido obtenidas para la relación del modelo con varios detectores en (Hilal Abdenour & Faouzi, 2006). Además, en (Meziani Abednour & Soltani, 20l0) se analizó el desempeño en ambientes multi-blanco y con bordes de cambio en el nivel del clutter para fondos que siguen la distribución Pearson y múltiples tipos de CFAR; así como variantes CFAR con lógica difusa descentralizada. Otros estudios han utilizado este modelo para probar esquemas de detección gracias a su sencilla definición (Cai, Ma, Hao, & Yang, 2009; Cai, Ma, Yan, & Hao, 2010).
La distribución Lévy coincide con la Inversa Gamma cuando su parámetro de forma es α=l/2 y el de escala b = γ 2/2, asumiendo que se utiliza la siguiente parametrización para la PDF del modelo Inverso Gamma:
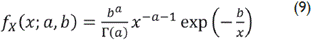
La CDF de la distribución Pearson es (Tsakalide et al.,2000):
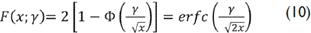
Donde Φ(. ) es la CDF de la distribución estándar Gaus-siana (O'Connor, 2011). Por su parte, erfc(. ) es la función de error complementaria (complementary error function), definida como (Walck, 2007):
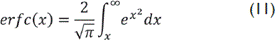
La generación de las muestras Lévy se implementó mediante el método de inversión descrito en (Gentle, 2003). Se halló el inverso de la CDF Pearson y se evaluó en que es una variable uniforme distribuida en el intervalo [0,1] . Luego, la siguiente expresión permite generar realizaciones de una variable Pearson:
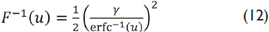
Donde erfc(.) es la función de error complementaria inversa definida como 1 - erfc(. )
El momento de orden n de la distribución Pearson se calcula según la expresión:
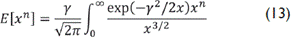
La cuál diverge para todas las n > 0, por lo que no existe una fórmula para la obtención a priori de los momentos Pearson a partir del conocimiento de los parámetros.
No se encontró ningún método de estimación de los parámetros Lévy en la literatura revisada. En consecuencia, el autor obtuvo expresiones de estimación por el método de MLE (Maximum Likelihood Estimate, Estimación por Máxima Verosimulitud) aplicando las pautas dadas en (Jae Myung, 2003) y los ejemplos ofrecidos en (Ginos, 2009) para otras distribuciones. A continuación se detalla el procedimiento.
Partiendo de la función de densidad de probabilidad Pearson:
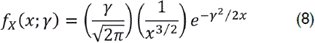
Se busca la función de verosimilitud (likelihood function) denotada como L (γ;x) que interpreta a γ como la variable independiente y a x como un parámetro. Esto se hace porque se dispone de un conjunto de muestras Pearson xi=x1,x2... xN, donde i es el número de la muestra y N es el total disponible. La función de verosimilitud total es la multiplicación de las funciones de verosimilitud aplicadas para cada xi:
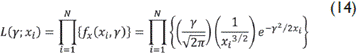
Generalmente se trabaja con la función logarítmica de verosimilitud (log-likelihood function) que ayuda a simplificar los cálculos que se hacen más adelante. La log-likelihood function (𝓛) resulta de hallar el logaritmo a la función de verosimilitud (L) por lo que transforma la productoria (Π) en una sumatoria (Σ).
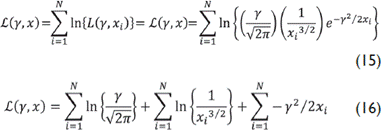
Ahora se procede a derivar 𝓛 con respecto a g para buscar los extremos (máximos y mínimos) de 𝓛. La función de verosimilitud comparte la misma localización de los máximos que la log-likelihood. También podía haberse trabajado con el logaritmo con base diez, pero en este caso la utilización del logaritmo natural es más ventajosa porque la función de densidad contiene un término exponencial.
La derivada de la log-likehoodfunction es:
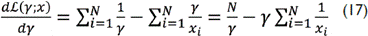
Se iguala la derivada a cero para buscar los puntos extremos o críticos:
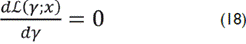
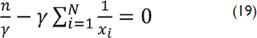
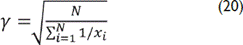
Esta última expresión es la estimación por MLE del parámetro de escala (γ) de la distribución Pearson. Para comprobar que el punto se trata de un máximo es necesario verificar que la segunda derivada es negativa en la vecindad de γ, lo cual siempre se cumple.
1.3. Distribución Lomax
El uso de la distribución Lomax para la modelación del clutterde radar fue sugerido recientemente en (Rosenberg & Bocquet, 2015; Weinberg, 2015) como reemplazo al modelo Pareto. Este último ha logrado muy buenos resultados en el ajuste del clutter de banda X y alto ángulo rasante (Farshchian & Posner, 2010; Weinberg, 2011a, 2011b) pero su parámetro de escala presenta inconvenientes para la detección. Precisamente, el modelo Lomax surge como alternativa fiable dado su alto grado de similitud con el Pareto. Propuesta por primera vez por Lomax en Lomax (1954) para modelar índices de fracasos de negocios (business data failure), la distribución es también conocida como la Pareto desplazada (shifted Pareto) ya que traslada el comportamiento Pareto al origen del eje de coordenadas.
Aunque de incipiente uso en temas de radares, la distribución Lomax ha demostrado gran versatilidad y capacidad de adaptación. Se ha utilizado en diversos campos como la modelación de la riqueza personal (Atkinson & Harrison, 1978), las proyecciones sobre las dimensiones de las empresas (Corbellini, Crosato, Ganugi, & Mazzoli, 2007), el crecimiento de los archivos y servidores de computadoras (Holland, Golaup, & Aghvami), la durabilidad de los componentes (Hassan & Al-Ghamdi, 2009) y el análisis de curvas características de operación (Campbell & Ratnaparkhi, 1993). La distribución Lomax también es conocida como la Pareto Generalizada de Tipo II (o Pareto Tipo II), la Pareto Americana, la Johnson de tipo VI y la Pearson tipo VI.
En el marco de los estudios de radar, en (Weinberg, 2015) se utilizó la siguiente expresión para la CDF Lomax:
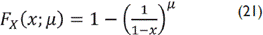
Donde µ, es el único parámetro de la distribución. En este artículo, sin embargo, se presenta la modelación matemática de la distribución Lomax en su versión bi-paramétrica. Las distribuciones bi-paramétricas son las más utilizadas en la modelación del cluttermarino (Machado Fernández, 2017), y modelaciones previas han sido ejecutadas con anterioridad en MATLAB para varias alternativas de dos parámetros (Machado Fernández, 2017a; José Raúl Machado Fernández & Jesús Concepción Bacallao Vidal, 2016).
La CDF de la distribución bi-paramétrica Lomax es (Tahir, Cordeiro, Mansoor, & Zubair, 2015):
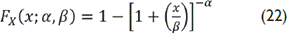
Donde α es el parámetro de forma y β es el de escala. Si se hace β =1 y α = µ, la expresión se reduce a la variante uniparamétrica dada en (20). Por su parte, la PDF del modelo tiene la forma (Gupta, Garg, & Gupta):
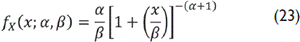
Los momentos algebraicos son los siguientes (Al-Noor & Saad Alwan, 2015), donde Γ(. ) es la función gamma:
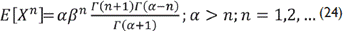
La generación de las muestras de la distribución Lomax se puede hacer a través del método de inversión (Al-Noor & Saad Alwan, 2015):
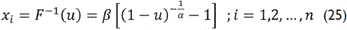
La estimación de los parámetros Lomax se implementó utilizando el tradicional Método de los Momentos (MoM, Method of Moments) que también ha sido aplicado en la modelación previa de las distribuciones Weibull, Log-Normal y K (Machado Fernández, 2017a; José Raúl Machado Fernández & Jesús Concepción Bacallao Vidal, 2016). Otros métodos alternativos de estimación son descritos en (Shakeel, Rehmat, & Ahsan ul Haq, 2017).
Los dos primeros momentos algebraicos Lomax pueden calcularse según (26) y (27). A partir de estas expresiones, se obtiene la estimación por MoM dada en (28) y (29).
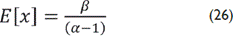
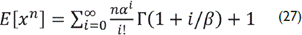
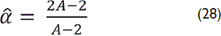
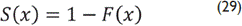
Donde A=E[x
2
]/E
2
[x], y son las estimaciones de los parámetros (α, β) de la distribución Lomax.
1.4. Funciones Implementadas
La Tabla 1 muestra las funciones que fueron implementadas en MATLAB para la modelación de la distribución Log-Wei-bull, junto a una breve descripción de cada una. Como puede apreciarse, las funciones comienzan todas con el prefijo lw_ que indica se corresponden a la distribución Log-Wei-bull. Funciones semejantes fueron implementadas para la Pearson y la Lomax aplicando los prefijos pea_ y lom_ respectivamente.
Tabla 1 Funciones de modelación de la distribución Log-Weibull implementadas en MATLAB.
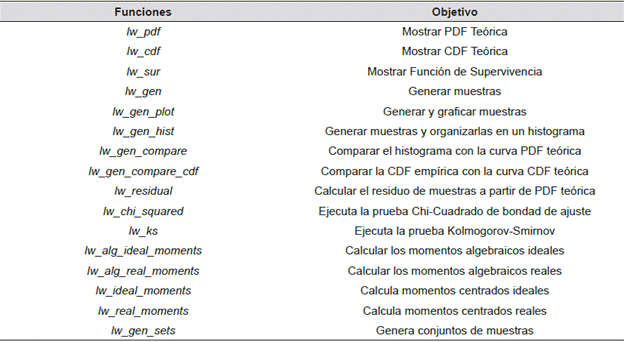
Fuente: El autor
Para la confección de las funciones lw_sur, pea_sury lom_ sur se utilizó la definición de función de supervivencia (S) dada en (30). Asimismo para la transformación de los momentos algebraicos en los centrados, y viceversa, se aplicaron las fórmulas (31) y (32) (Walck, 1991):
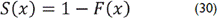
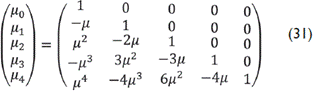
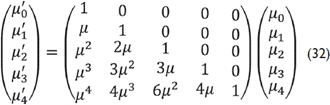
Donde µn son los momentos algebraicos de orden n y µn los momentos centrados de orden n.
2. Resultados y Discusión
La modelación de las distribuciones Log-Weibull, Pearson y Lomax partió de la simulación de las curvas de PDF que fueron comparadas con similares dadas por otros autores. Este primer paso de verificación fue seguido por sucesivas interacciones entre las funciones implementadas que garantizaban la correcta correspondencia entre los diferentes componentes de la modelación.
Específicamente, las curvas de la PDF Log-Weibull fueron comparadas exitosamente con las dadas en (Alzaatreh et al., 2013) y las de la PDF Lomax con las de (Baker, 2014). Por su parte, la PDF Pearson fue relacionada con las publicaciones de (McLaughlin, 2014; Roth, 2013) donde se trataba la distribución Inversa Gamma que coincide con la Pearson cuando para α=1/2; b = γ2/2.
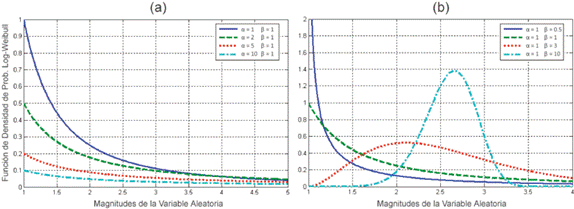
Un ejemplo de curvas de la PDF se muestra en la Figura 1 (a y b) donde se ilustra la influencia de la modificación de los parámetros de la Log-weibull sobre los trazos. Obtenidos con la función lw_pdf los resultados reflejan la importante modificación que ocurre cuando se varía el parámetro de forma (b), en contraste con la variación del parámetro α (a) que solo modifica la escala de las muestras.
Fuente: El autor
Figura 1 Influencia de la modificación de los parámetros de la distribución Log-Weibull sobre las curvas de la PDF.
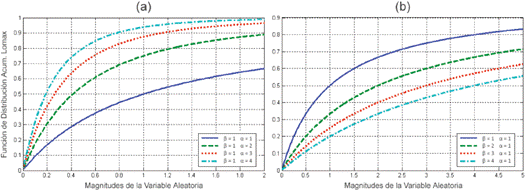
Otra manera habitual de representar distribuciones estadísticas es mediante el uso de la CDF que indica la probabilidad de que una variable tome un valor igual o menor al tabulado en el eje de la abscisas. La Figura 2 (a y b) presenta ejemplos de la CDF Lomax donde se varía el parámetro de forma (α) a la izquierda y el de escala (β) a la derecha. Las gráficas fueron elaboradas con la función lom_cdf.
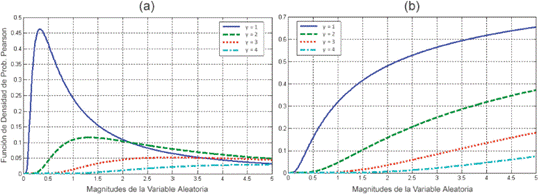
La distribución Pearson, a diferencia de la Log-Weibull y la Lomax, es uni-paramétrica, lo que permite resumir su comportamiento en la Figura 3 (a y b). Obsérvese como para g=1 el área ocupada por la PDF (a) por debajo de la magnitud 5 es significativa. Esto hace que el trazo de la CDF (b) tienda rápidamente a 1. En cambio, a medida que se aumenta se eleva tanto la media como la varianza de las muestras, lo que se traduce en curvas de PDF más alargadas, cuyas representaciones de CDF tardan más en tender a 1.
Fuente: El autor
Figura 3 Alteración de las curvas de PDF y CDF como resultado de la variación del parámetro de escala Pearson.
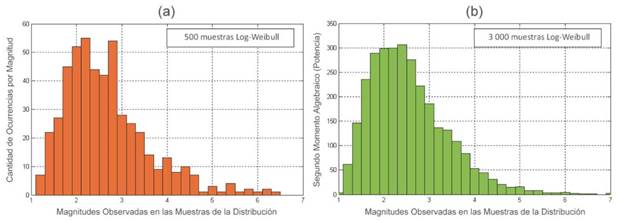
Cuando se generan muestras de una distribución, la representación de las magnitudes obtenidas en una serie de tiempo no permite identificar claramente el modelo que originó las realizaciones. Para descubrir la distribución a la cuál pertenecen un grupo de muestras se construyen histogramas, como los de la Figura 4 que fueron creados con la función lw gen hist. El lector podrá notar como el aumento de la cantidad de muestras hace que el gráfico tienda cada vez más a la forma teórica esperada de la distribución Log-Weibull.
Fuente: El autor
Figura 4 Convergencia del histograma hacia la forma esperada con el aumento de la cantidad de muestras de la distribución Log-Weibull.
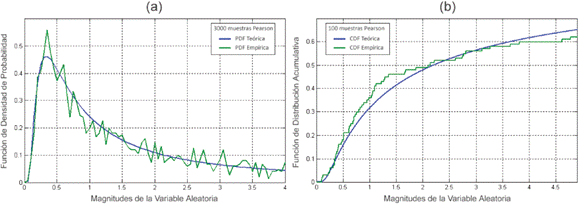
La Figura 5 revela la convergencia de los histogramas (PDF empírica) a la curva teórica esperada (PDF teórica) para la distribución Pearson. Esta gráfica es una de las más importantes pues relaciona la generación de muestras con el modelo esperado y demuestra que la implementación fue realizada correctamente. Las PDF empírica de las tres distribuciones tratadas osciló alrededor de los trazos teóricos, lo cual fue comprobado con la función pea_gen_compare y similares.
Fuente: El autor
Figura 5 Comparación entre PDF y CDF teórica y empírica para la distribución Pearson.
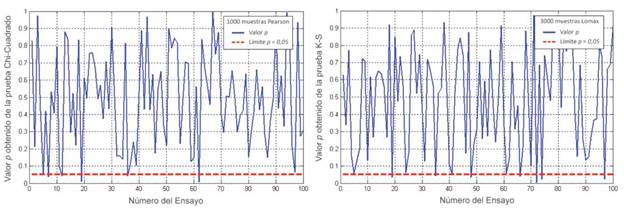
La pertenencia de las muestras generadas a cada una de las distribuciones fue verificada además aplicando pruebas de bondad de ajuste. La ejecución de las conocidas pruebas Chi-Cuadrado (Chi-Squared) y Kolmogorov-Smirnov (K-S) para las distribuciones Pearson y Lomax se muestra en la Figura 6. Como puede apreciarse, la hipótesis de pertenencia se rechaza con baja frecuencia ya que las pruebas producen valores p > 0,05. Esto indica que la generación fue ejecutada correctamente.
Fuente: El autor
Figura 6 Resultados de la aplicación de las pruebas de Chi-Cuadrado y Kolmogorov-Smirnov sobre conjuntos de muestras Pearson y Lomax.
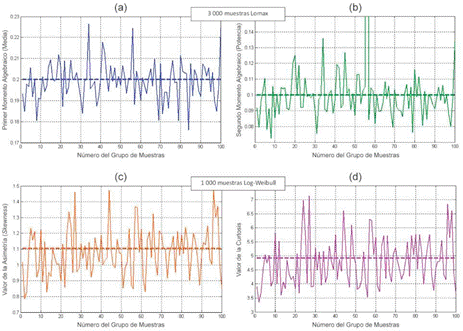
El cálculo de la media y la varianza Lomax y de la asimetría y la curtosis Log-Weibull se ofrece en la Figura 7. Las estimaciones realizadas sobre 100 conjuntos de muestras oscilan alrededor del valor teórico esperado. Los errores obtenidos son reducidos y se distribuyen igualmente entre errores por defecto y por exceso, lo cual es un comportamiento adecuado para un estimador.
Fuente: El autor
Figura 7 Oscilación de los media y la varianza Lomax, y de la asimetría y la curtosis Log-Weibull alrededor de los valores teóricos.
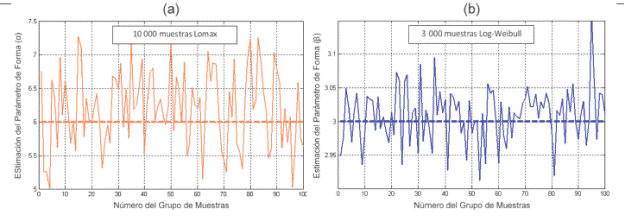
La estimación de los parámetros de forma de 100 conjuntos de muestras de las distribuciones Lomax y Log-weibull se ilustra en la figura 8. En este caso, la estimación Lomax exhibe errores mayores que la Log-Weibull, aun cuando se utiliza una mayor cantidad de muestras. El comportamiento tiene explicación en la utilización del método de los momentos para Lomax, el cual brinda un resulta muy rápido pero con baja precisión. En efecto, el algoritmo de máxima verosimilitud aplicado para Log-Weibull es más costoso computacionalmente pero alcanza mejores resultados. En la práctica se establece un compromiso entre velocidad y precisión según la aplicación tratada. Generalmente, en ambientes de radares se requiere de una alta velocidad que no retrase la operación global del detector.
Fuente: El autor
Figura 8 Estimaciones de los parámetros de forma Lomax y Log-Weibull cercanas al valor esperado.
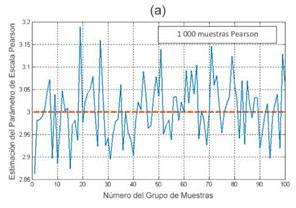
Por último, tras ejecutar pruebas con 100 conjuntos de 1000 muestras cada uno, la variación de la estimación del parámetro Pearson se ilustra en la Figura 9. Dada la simplicidad matemática de la distribución, el estimador de los parámetros por máxima verosimilitud toma una forma sencilla que produce resultados tanto rápidos como precisos.
3. Valoración del Estudio
El presente artículo partió de una revisión bibliográfica importante que permitió recoger en un solo documento las definiciones matemáticas de tres distribuciones estadísticas, novedosas en la modelación del cluttermarino pero aún de limitada aplicación. La revisión corrigió ligeras imprecisiones producto de la efímera presencia de las distribuciones en los textos vinculados, obteniéndose también expresiones en casos donde no existía una referencia clara.
Las expresiones encontradas fueron incluidas en una pequeña librería creada en la herramienta matemática MAT-LAB, que a pesar de ser muy utilizada en desarrollos de radar y de contener un Toolbox dedicado exclusivamente a distribuciones estadísticas, no incluye a la Log-Weibull, la Pearson y la Lomax. El código creado también incluyó mecanismos adicionales encaminados a validar la implementación por comparación con resultados dados por otros autores y mediante la interacción de las propias funciones.
La modelación de las distribuciones Log-Weibull, Pearson y Lomax se une a esfuerzos anteriores que han abordado las distribuciones Rayleigh, Exponencial, Gamma, Log-Normal, Weibull, K y Pareto (Machado Fernández, 2016a, 2016b, 2017a; José Raúl Machado Fernández & Jesús Concepción Bacallao Vidal, 2016), con el objetivo común de crear la librería MATE-CFAR 2 que incluirá múltiples modelos y procesadores de radar, siendo una progresión del MATE-CFAR original presentado en (Machado Fernández & Bacallao Vidal, 2014). Conjuntamente, la nueva modelación permitirá crear nuevas alternativas de detección adaptadas a diferentes condiciones de la superficie marina, como los procesadores inteligentes que han sido desarrollados con anterioridad para las distribuciones Weibull, K y Pareto (Machado Fernández, 2015; José Raúl Machado Fernández & Jesús C. Bacallao Vidal, 20l6a, 20l6b, 20l6c; Machado Fernández, Bacallao Vidal, & Chávez Ferry, 20l5). Estos procesadores utilizan la modelación de las distribuciones en MATLAB como base para crear una solución adaptativa que estima los parámetros de forma y escala para elegir las variables óptimas de operación del detector CFAR. Además, se planea la traducción del código a otros lenguajes como Python para hacer la implementación aún más accesible.
El presente artículo también contribuye a mejorar los ajustes que se realizan sobre datos de clutter, ya que ahora se dispondrá de una mayor cantidad de distribuciones candidatas que permitirán arribar a conclusiones definitivas sobre el comportamiento electromagnético de los ecos de radar. Conjuntamente, la diferenciación entre distribuciones estadísticas puede utilizarse para identificar condiciones marinas anómalas de interés ecológico como son los bancos de peces (Fialkowski, Gauss, & Drumheller, 2004)ar>2013</ year></dates><publisher>Department of Electrical, los restos de embarcaciones (Abraham & Preston, 2010; Preston & Abraham, 2015) y los derrames de petróleo (Fingas, 2015; Qi & Zhao, 2015). Estas condiciones pueden manifestarse como cambios en la distribución preferencial del fondo.
4. Conclusiones e Investigaciones Futuras 9
Fueron implementadas y validadas un total de 48 funciones informáticas para la modelación de las distribuciones Log-Weibull, Pearson y Lomax, de aplicación novedosa en la representación del clutter de radar. El trabajo realizado además de recoger en un solo documento definiciones poco abordadas en la literatura, alcanzó a suplir las deficiencias de la herramienta matemática MATLAB que no cuenta con soluciones para las distribuciones abordadas. Así, se obtuvo un producto informático valioso para la realización de estudios sobre el eco electromagnético obtenido de las superficies terrestres y marinas, con aplicaciones en la creación 12. de nuevos detectores de radar y en la esfera ecológica. Se prevé la futura traducción de las funciones implementadas l3. hacia otros lenguajes de programación como Python, y la inclusión de los resultados en la librería MATE-CFAR 2.

