<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>0120-0690</journal-id>
<journal-title><![CDATA[Revista Colombiana de Ciencias Pecuarias]]></journal-title>
<abbrev-journal-title><![CDATA[Rev Colom Cienc Pecua]]></abbrev-journal-title>
<issn>0120-0690</issn>
<publisher>
<publisher-name><![CDATA[Facultad de Ciencias Agrarias, Universidad de Antioquia]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S0120-06902009000100003</article-id>
<title-group>
<article-title xml:lang="en"><![CDATA[GEPRO: Gene Expression Profiler for DNA microarray data]]></article-title>
<article-title xml:lang="es"><![CDATA[GEPRO: Analizador de Expresión Genética para datos provenientes de microarreglos de DNA]]></article-title>
<article-title xml:lang="pt"><![CDATA[GEPRO: Analisador de Expressão Gênica para dados provenientes de microarranjos de DNA]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Kim]]></surname>
<given-names><![CDATA[Beob G]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Lindemann]]></surname>
<given-names><![CDATA[Merlin D]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Bridges]]></surname>
<given-names><![CDATA[Phillip J]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Ko]]></surname>
<given-names><![CDATA[CheMyong]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,University of Kentucky Department of Animal and Food Sciences ]]></institution>
<addr-line><![CDATA[Lexington ]]></addr-line>
<country>USA</country>
</aff>
<aff id="A02">
<institution><![CDATA[,University of Kentucky Department of Clinical Sciences ]]></institution>
<addr-line><![CDATA[Lexington ]]></addr-line>
<country>USA</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>03</month>
<year>2009</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>03</month>
<year>2009</year>
</pub-date>
<volume>22</volume>
<numero>1</numero>
<fpage>12</fpage>
<lpage>18</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_arttext&amp;pid=S0120-06902009000100003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_abstract&amp;pid=S0120-06902009000100003&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_pdf&amp;pid=S0120-06902009000100003&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="en"><p><![CDATA[The DNA microarray technology has been widely employed in recent biological research. However, the unprecedented large amount of data produced by the technology has presented inevitable challenges to biological scientists, forcing individual researchers to take extensive training or rely on database specialists for the use of the data. Microsoft Excel® has a number of convenient functions and may be the most widely used spreadsheet package for data storage and manipulation. Therefore, we developed a userfriendly, Excel spreadsheet-based microarray data-managing program. The program, gene expression profiler (GEPRO), is designed to facilitate organizing miocroarray data, performing statistical analysis, and displaying the results. Using GEPRO&rsquo;s filtering and sorting capabilities, a user can easily identify differentially expressed genes, display the expression profiles of the genes of interest, and present and save the analyzed data in a user-defined way. The versatility and utility of GEPRO should enable bench work researchers to maximize the use of their microarray data. The GEPRO is freely available for noncommercial users at <A HREF="http://www.mc.uky.edu/cls/ko/gepro1.html">http://www.mc.uky.edu/cls/ko/gepro1.html</A>.]]></p></abstract>
<abstract abstract-type="short" xml:lang="es"><p><![CDATA[La tecnología de microarreglos de DNA es actualmente empleada de manera amplia en investigación biológica. Sin embargo, el manejo de la enorme cantidad de datos generados por la misma representa un desafió para los investigadores, forzándolos a invertir valioso tiempo en capacitación sobre dicho manejo, o a confiar el uso de la misma a especialistas en bases de datos. El programa Excel® de Microsoft, la hoja de calculo mas ampliamente utilizada a nivel mundial, que cuenta con muchas funciones útiles para almacenamiento y manipulación de datos, fue utilizado por nosotros para desarrollar una aplicación amigable para el manejo de datos generados por microarreglos de DNA. Nuestro programa, llamado &ldquo;Gene Expression Profiler&rdquo; (GEPRO), esta diseñado para facilitar la organización de datos de microarreglos, realizar su análisis estadístico, y presentar los resultados. Utilizando la posibilidad de filtrado y ordenamiento de datos que ofrece GEPRO, el usuario puede identificar fácilmente diferentes genes, observar los perfiles de expresión de los genes de interés, así como presentar y guardar los datos de diversas maneras. La versatilidad y utilidad de GEPRO ayuda a los investigadores a maximizar la utilización de sus datos de microarreglos. GEPRO es una aplicación gratuita, disponible para uso no comercial en <A HREF="http://www.mc.uky.edu/cls/ko/gepro1.html">http://www.mc.uky.edu/cls/ko/gepro1.html</A>.]]></p></abstract>
<abstract abstract-type="short" xml:lang="pt"><p><![CDATA[A Tecnologia dos Mircroarranjos de DNA é muito empregada em pesquisa biológica. Mas o manejo da grande quantidade de dados gerados é um desafio para os pesquisadores, os quais estão sendo forçados a realizar grandes investimentos econômicos e de tempo para sua capacitação ou em confiar em expertos da informática para analisar seus dados. O programa Excel® da Microsoft, amplamente utilizada no mundo foi utilizado para desenvolver uma aplicação amigável para o manejo de dados gerados por Mircroarranjos de DNA. O nosso programa, chamado &ldquo;Gene Expression Profiler&rdquo; (GEPRO), está desenhado para facilitar a organização de dados, permite realizar as respectivas análises estatísticas e apresentar os resultados. Utilizando a possibilidade de filtrar e organizar os dados que oferece GEPRO, o usuário pode identificar pares de genes, observarem os perfis da expressão dos genes de interesse, assim como a possibilidade de apresentar e salvar os dados de diferentes formas. A versatilidade e a utilidade do programa, ajuda aos pesquisadores a maximizar a utilização dos dados. GEPRO é uma aplicação gratuita para uso não comercial, disponível em <A HREF="http://www.mc.uky.edu/cls/ko/gepro1.html">http://www.mc.uky.edu/cls/ko/gepro1.html</A>.]]></p></abstract>
<kwd-group>
<kwd lng="en"><![CDATA[database]]></kwd>
<kwd lng="en"><![CDATA[gene expression]]></kwd>
<kwd lng="en"><![CDATA[microarray]]></kwd>
<kwd lng="en"><![CDATA[Microsoft Excel]]></kwd>
<kwd lng="es"><![CDATA[bases de datos]]></kwd>
<kwd lng="es"><![CDATA[Excel de Microsoft]]></kwd>
<kwd lng="es"><![CDATA[expresión de genes]]></kwd>
<kwd lng="es"><![CDATA[microarreglos]]></kwd>
<kwd lng="pt"><![CDATA[bases de dados]]></kwd>
<kwd lng="pt"><![CDATA[Excel de Microsoft]]></kwd>
<kwd lng="pt"><![CDATA[expressão gênica]]></kwd>
<kwd lng="pt"><![CDATA[microarranjos]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="right"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Art&iacute;culos originales </b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="4"> <b>GEPRO: Gene Expression Profiler for DNA microarray data <Sup>&#164; </Sup></b></font></p>     <p><b><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><I>GEPRO: Analizador de Expresi&oacute;n Gen&eacute;tica para datos provenientes de microarreglos de DNA </I></font></b></p>     <p><b><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><I>GEPRO: Analisador de Express&atilde;o G&ecirc;nica para dados provenientes de microarranjos de DNA </I></font></b><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><I></I></font></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Beob G Kim<Sup><I>1*</I></Sup>, Animal Science, PhD; Merlin D Lindemann<Sup><I>1</I></Sup>, Animal Science, PhD; Phillip J Bridges<Sup><I>2</I></Sup>,  Animal Science, PhD; CheMyong Ko<Sup><I>2*</I></Sup>, Biology, PhD.  </b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><Sup><Sup><I>1 </I></Sup></Sup><I>Departmen</I><I>t </I><I>o</I><I>f </I><I>Anima</I><I>l </I><I>an</I><I>d </I><I>Foo</I><I>d </I><I>Sciences</I><I>, </I><I>Universit</I><I>y </I><I>o</I><I>f </I><I>Kentucky</I><I>, </I><I>Lexington</I><I>, </I><I>K</I><I>Y </I><I>40546</I><I>, </I><I>USA</I><Sup><Sup><I>    <br>   2 </I></Sup></Sup><I>Departmen</I><I>t </I><I>o</I><I>f </I><I>Clinica</I><I>l </I><I>Sciences</I><I>, </I><I>Universit</I><I>y </I><I>o</I><I>f </I><I>Kentucky</I><I>, </I><I>Lexington</I><I>, </I><I>K</I><I>Y </I><I>40536</I><I>, </I><I>US</I><I>A </I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I>(Recibido: 29 enero, 2009; aceptado: 12 febrero, 2009)</I></font></p>     <p>&nbsp;</p>   <hr size="1">       ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I><b>Summary </b></I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I>The DNA microarray technology has been widely employed in recent biological research. However, the unprecedented large amount of data produced by the technology has presented inevitable challenges to biological scientists, forcing individual researchers to take extensive training or rely on database specialists for the use of the data. Microsoft Excel&#174; has a number of convenient functions and may be the most widely used spreadsheet package for data storage and manipulation. Therefore, we developed a userfriendly, Excel spreadsheet-based microarray data-managing program. The program, gene expression profiler (GEPRO), is designed to facilitate organizing miocroarray data, performing statistical analysis, and displaying the results. Using GEPRO&rsquo;s filtering and sorting capabilities, a user can easily identify differentially expressed genes, display the expression profiles of the genes of interest, and present and save the analyzed data in a user-defined way. The versatility and utility of GEPRO should enable bench work researchers to maximize the use of their microarray data. The GEPRO is freely available for noncommercial users at <a href="http://www.mc.uky.edu/cls/ko/gepro1.html" target="_blank">http://www.mc.uky.edu/cls/ko/gepro1.html</a>. </I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Key words:</b> <I>database, gene expression, microarray, Microsoft Excel . </I></font></p>     <p>&nbsp;</p>   <hr size="1">       <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I><b>Resumen</b></I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I>La tecnolog&iacute;a de microarreglos de DNA es actualmente empleada de manera amplia en investigaci&oacute;n biol&oacute;gica. Sin embargo, el manejo de la enorme cantidad de datos generados por la misma representa un </I><I>desafi&oacute; para los investigadores, forz&aacute;ndolos a invertir valioso tiempo en capacitaci&oacute;n sobre dicho manejo, o a confiar el uso de la misma a especialistas en bases de datos. El programa Excel&#174; de Microsoft, la hoja de calculo mas ampliamente utilizada a nivel mundial, que cuenta con muchas funciones &uacute;tiles para almacenamiento y manipulaci&oacute;n de datos, fue utilizado por nosotros para desarrollar una aplicaci&oacute;n amigable para el manejo de datos generados por microarreglos de DNA. Nuestro programa, llamado &ldquo;Gene Expression Profiler&rdquo; (GEPRO), esta dise&ntilde;ado para facilitar la organizaci&oacute;n de datos de microarreglos, realizar su an&aacute;lisis estad&iacute;stico, y presentar los resultados. Utilizando la posibilidad de filtrado y ordenamiento de datos que ofrece GEPRO, el usuario puede identificar f&aacute;cilmente diferentes genes, observar los perfiles de expresi&oacute;n de los genes de inter&eacute;s, as&iacute; como presentar y guardar los datos de diversas maneras. La versatilidad y utilidad de GEPRO ayuda a los investigadores a maximizar la utilizaci&oacute;n de sus datos de microarreglos. GEPRO es una aplicaci&oacute;n gratuita, disponible para uso no comercial en <a href="http://www.mc.uky.edu/cls/ko/gepro1.html" target="_blank">http://www.mc.uky.edu/cls/ko/gepro1.html</a>. </I></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Palabras clave<I>:</I></b><I> bases de datos, Excel de Microsoft, expresi&oacute;n de genes, microarreglos.</I></font></p>     <p>&nbsp;</p> <hr size="1">     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I><b>Resumo</b></I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I>A Tecnologia dos Mircroarranjos de DNA &eacute; muito empregada em pesquisa biol&oacute;gica. Mas o manejo da grande quantidade de dados gerados &eacute; um desafio para os pesquisadores, os quais est&atilde;o sendo for&ccedil;ados a realizar grandes investimentos econ&ocirc;micos e de tempo para sua capacita&ccedil;&atilde;o ou em confiar em expertos da inform&aacute;tica para analisar seus dados. O programa Excel&#174; da Microsoft, amplamente utilizada no mundo foi utilizado para desenvolver uma aplica&ccedil;&atilde;o amig&aacute;vel para o manejo de dados gerados por Mircroarranjos de DNA. O nosso programa, chamado &ldquo;Gene Expression Profiler&rdquo; (GEPRO), est&aacute; desenhado para facilitar a organiza&ccedil;&atilde;o de dados, permite realizar as respectivas an&aacute;lises estat&iacute;sticas e apresentar os resultados. Utilizando a possibilidade de filtrar e organizar os dados que oferece GEPRO, o usu&aacute;rio pode identificar pares de genes, observarem os perfis da express&atilde;o dos genes de interesse, assim como a possibilidade de apresentar e salvar os dados de diferentes formas. A versatilidade e a utilidade do programa, ajuda aos pesquisadores a maximizar a utiliza&ccedil;&atilde;o dos dados. GEPRO &eacute; uma aplica&ccedil;&atilde;o gratuita para uso n&atilde;o comercial, dispon&iacute;vel em <a href="http://www.mc.uky.edu/cls/ko/gepro1.html" target="_blank">http://www.mc.uky.edu/cls/ko/gepro1.html</a>. </I></font></p>    ]]></body>
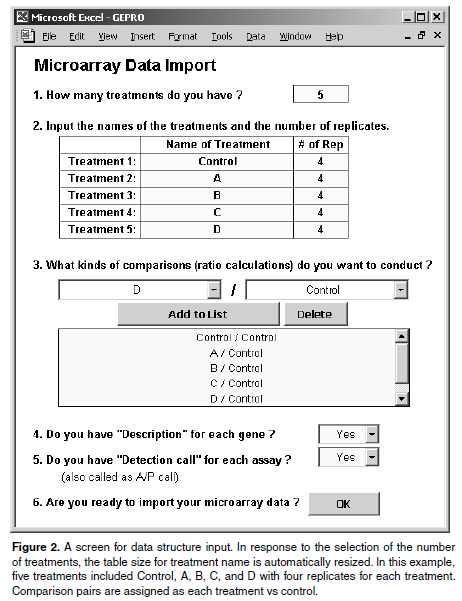
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Palavras chave:</b> <I>bases de dados; Excel de Microsoft, express&atilde;o g&ecirc;nica, microarranjos.</I></font></p>     <p>&nbsp;</p> <hr size="1">     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Introduction</b></font></p>      <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Improvements of nano-technology and biomolecular techniques have led to the development of microarray systems, which allow individual bench researchers to measure gene expression at the genome level. Accordingly, microarray technology has been widely employed in biological research in recent years. However, the nature of generating large data sets from individual microarray experiments has presented challenges for data collection, exchange, and analysis. Although there are now widely accepted formats for microarray data, because of the enormous data size of each microarray data set, it is difficult for an investigator to put the data together to build and populate large-scale databases (13). </font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">While programs have been developed for the management of data, most of them require extensive knowledge of statistics and computer skills (4, 5, 15), which limits their value for some researchers. Therefore, user-friendly software has been awaited that would allow individual bench work researchers to manage their own microarray data. In an effort to disseminate and share microarray data via online, we recently built a web-based rat ovarian gene expression database (rOGED) that performs a key-word driven data search, execute a programmed statistical analysis and presents data as tables and graphs (7). </font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Now, we report the development of a Microsoft Excel&#174; (<a href="http://www.microsoft.com" target="_blank">www.microsoft.com</a>) spreadsheet-based software tool with which a bench work researcher can easily build his/her own microarray database. The software, gene expression profiler (GEPRO), can perform statistical analysis, identify genes of interest, and present data in a user-defined format. The GEPRO was developed using Microsoft Excel mainly because of its familiarity to bench work researchers and its versatility. A variety of software tools built on Excel are currently being used in the areas of animal science (10), physiology (2), pharmacology (3), and GEPRO.xls with no special installation. When this biochemistry (14) as well as molecular biology in file is opened, a user needs to click on the Enable managing gene expression data (6, 8, 11). </font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Program description and sample run</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">The GEPRO source codes for all the modules   have been written in Visual Basic for Application as   an Excel XP add-in. A user can run the program file   GEPRO.xls with no special installation. When this   file is opened, a user needs to click on the Enable   Macros button in a dialogue box. A flow chart   illustrating the program is presented in <a href="#f1">figure 1</a>. The   GEPRO database set-up falls into four procedures:   1) data structure input, 2) microarray data input, 3)   statistical computation, and 4) display as tables and   charts on the main screen. The functions include   search, filtering, sorting and chart exporting and are   all performed on the main screen.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><img src="/img/revistas/rccp/v22n1/v22n1a03f01.jpg"><a name="f1"></a></font></p>     ]]></body>
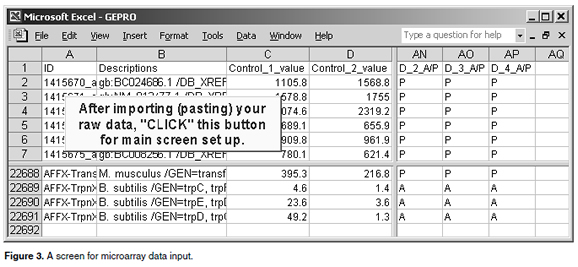
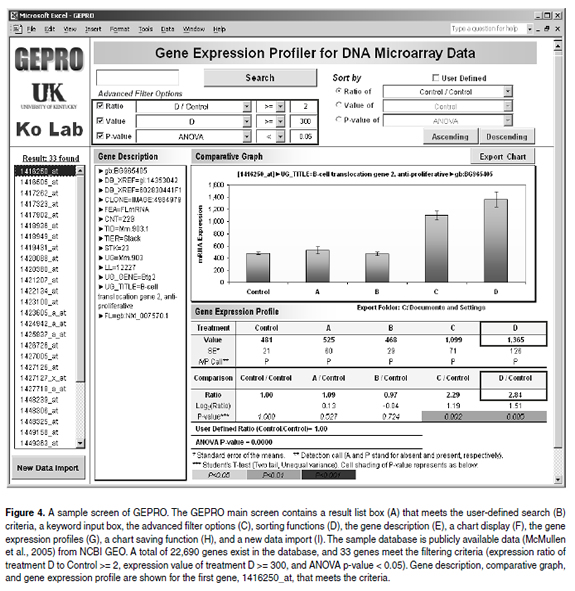
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Data structure input</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">The first step of the GEPRO database setup   is data structure input (<a href="#f2">see Figure 2</a>). A user   inputs the number of treatments, the name of   each treatment, and the number of replicates   for each treatment. The user then assigns the   comparison pairs of treatments for expression   ratio calculation and Studentâ€™s T-test and   provides input that indicates whether gene   descriptions and detection calls are available.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  When the user finishes this step by clicking the   OK button, the program generates a spreadsheet   for the microarray data input.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><img src="/img/revistas/rccp/v22n1/v22n1a03f02.jpg"><a name="f2"></a></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Microarray data input</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  An Excel spreadsheet for microarray data input   is presented in figure 3. In this spreadsheet, the   first row shows the title of each column including   gene ID, gene description, and the name and   replicate of treatment for the expression value   and detection call according to the data structure   input. Following the order of the columns, the   user prepares microarray data in a spreadsheet,   makes a copy, and pastes the data into the data   input sheet of GEPRO.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  Statistical computation</font></p>     ]]></body>
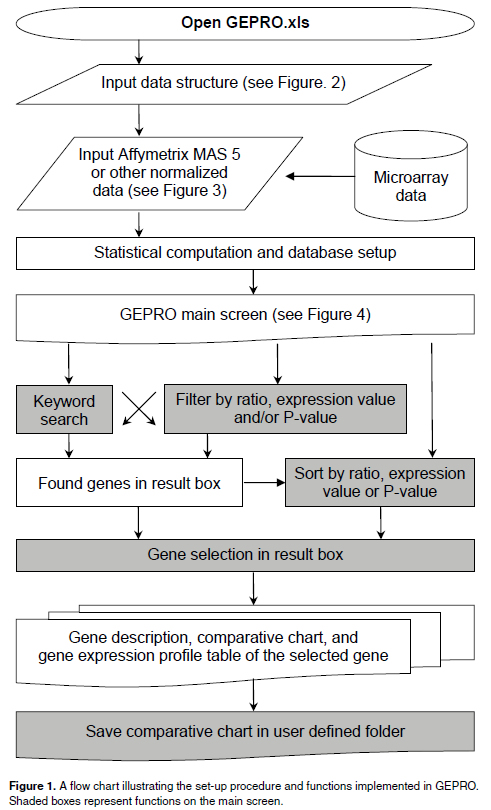
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> When a user clicks the button for main screen   setup (<a href="#f3">see Figure 3</a>), statistical computations are   performed generating treatment means, standard   errors, expression ratios between comparison pairs,   p-values from unequal variance Studentâ€™s T-test, and   p-values from one way ANOVA tests. The treatment   pairs for expression ratio and Studentâ€™s T-test were   assigned during the data structure input procedure.   These statistics are tabulated on the main screen   with a corresponding chart (<a href="#f4">see Figure 4</a>).</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><img src="/img/revistas/rccp/v22n1/v22n1a03f03.jpg"><a name="f3"></a></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><img src="/img/revistas/rccp/v22n1/v22n1a03f04.jpg"><a name="f4"></a></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&nbsp;</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><I>Descriptio</I><I>n </I><I>an</I><I>d </I><I>function</I><I>s </I><I>o</I><I>f </I><I>mai</I><I>n </I><I>scree</I><I>n </I></font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">When a user performs a search, a list of gene IDs matching the search criteria appear in the result list box on the left corner of the GEPRO (<a href="#f4">see Figure 4A</a>). The user can display gene expression profiles of the genes of interest by clicking the individual gene IDs; in response to the selection of a gene ID in the list box, the corresponding gene description, chart, and table are instantly updated and displayed (<a href="#f4">see Figures 4E, 4F and 4G</a>). </font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">The Search button (<a href="#f4">see Figure 4B</a>) enables filtering genes containing a keyword in the description (<a href="#f4">see Figure 4E</a>). Advanced filter options (<a href="#f4">see Figure 4C</a>) enable filtering by a ratio of gene expressions between two comparison groups, by an expression value of an experimental treatment, and/ or a p-value from statistical tests. Genes listed in the result list box (<a href="#f4">see Figure 4A</a>) can be rearranged by expression ratios, expression values, or p-values by using the sorting function (<a href="#f4">see Figure 4D</a>). </font></p>    <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">In addition, a user can modify chart formats, types, source data, or chart options using Excel chart functions. Finally, the Export Chart button (<a href="#f4">see Figure 4H</a>) allows a user to save the current chart as GIF image file in a folder assigned by the user. The New Data Import button (<a href="#f4">see Figure 4I</a>) enables a new database set-up. When a user clicks this button, a sheet for data structure input appears (<a href="#f2">see Figure 2</a>). </font></p>     ]]></body>
<body><![CDATA[<p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Discussion</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">In this paper, we report the development of a user-friendly, Excel spreadsheet-based GEPRO that allows users to easily build their own microarray database, identify genes of interest and, thus, maximize the use of the data produced from microarray. In GEPRO, a user imports original microarray data, annotation information and other relevant information in a guided manner. This program has search, filtering, and charting capabilities that allow researchers to identify differentially expressed genes and to display the gene expression profiles. The program also enables a user to easily change the display format or options of charts using Excel functions and to save charts in a user-defined folder. Additionally, GEPRO enables individual researchers to build their own gene expression databases using publicly available resources such as microarray data deposited in SAGE (9) or NCBI GEO (1). </font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">The GEPRO is powerful, quick, and easy-touse software for researchers to organize microarray data, identify potentially important genes in their databases, and display the expression of those genes of interest. The greatest benefit of using GEPRO is that a user can use microarray data repeatedly and instantly, combine multiple sets of microarray data into one database, and utilize microarray data deposited in public domains. The GEPRO is freely available for non-commercial users. The GEPRO, sample database, sample microarray data, and supplemental information can be downloaded from <a href="http://www.mc.uky.edu/cls/ko/gepro1.html" target="_blank">http://www.mc.uky.edu/cls/ko/gepro1.html</a>.</font></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Acknowledgement</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">The authors thank Dr. Arnold J. Stromberg (Department of Statistics, University of Kentucky) for his helpful comments on the GEPRO and the manuscript.</font></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>References</b></font></p>     <!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">1. Barrett T, Suzek TO, Troup DB, Wilhite SE, Ngau WC,   Ledoux P, Rudnev D, Lash AE et al. NCBI GEO: mining   millions of expression profiles-database and tools. Nucleic Acids Res 2005; 33: D562-D566.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000062&pid=S0120-0690200900010000300001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  2. Brown AM. A non-linear regression analysis program   for describing electrophysiological data with multiple   functions using Microsoft Excel, Comput. Meth. Prog.   Biomed 2006; 82: 51-57.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000063&pid=S0120-0690200900010000300002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  3. Dansirikul C, Choi M, and Duffull SB. Estimation of   pharmacokinetic parameters from non-compartmental   variables using Microsoft ExcelÂ®. Comput. Biol. Med   2005; 35: 389-403.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000064&pid=S0120-0690200900010000300003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  4. Gentleman RC, Carey VJ, Bates DM, Bolstad B, Dettling M, et   al. Bioconductor: open software development for computational   biology and bioinformatics. Genome Biol 2004; R80.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000065&pid=S0120-0690200900010000300004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  5. Heyer LJ, Moskowitz DZ, Abele JA, Karnik P, Choi D,   et al. MAGIC Tool: integrated microarray data analysis.   Bioinformatics 2005; 21: 2114-2115.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000066&pid=S0120-0690200900010000300005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">6. Hulshizer R, Blalock EM. Post hoc pattern matching:   assigning significance to statistically defined expression   pattern in single channel microarray data. BMC Bioinformatics 2007; 8: 240.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000067&pid=S0120-0690200900010000300006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  7. Jo M, Gieske MC, Payne CE, Wheeler-Price SE, Gieske   JB, et al. Development and application of a rat ovarian   gene expression database (rOGED). Endocrinol 2004. 145:   5384-5396.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000068&pid=S0120-0690200900010000300007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  8. Khan HA. ArraySolver: an algorithm for color-coded   graphical display and Wilcoxon signed-rank statistics for   comparing microarray gene expression data. Comput Func   Genom 2004; 5: 39-47.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000069&pid=S0120-0690200900010000300008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  9. Lash AE, Tolstoshev CM, Wagner L, Schuler GD,   Strausberg RL, et al. SAGEmap: a public gene expression   resource. Genome Res 2000; 10: 1051-1060.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000070&pid=S0120-0690200900010000300009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  10. Lindemann MD, Kim BG. Technical note: A model to   estimate individual feed intake of swine in group feeding.   J. Anim. Sci 2007; 85: 972-975.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000071&pid=S0120-0690200900010000300010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  11. Liu H, Tarima S, Borders AS, Getchell TV, Getchell ML,   et al. Quadratic regression analysis for gene discovery   and pattern recognition for non-cyclic short time-course   microarray experiments. BMC Bioinformatics 2005; 6: 106.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000072&pid=S0120-0690200900010000300011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  12. McMullen CA, Moylan J, Reid MB, Andrade FH. C2C12   transcriptome changes in response to hydrogen peroxide.   NCBI GEO 2005; (Accessed Feb 10, 2009) URL:   <a href="http://www.ncbi.nlm.nih.gov/projects/geo/query/acc.cgi?acc=GSE3078/" target="_blank">http://www.ncbi.nlm.nih.gov/projects/geo/query/acc.cgi?acc=GSE3078/</a>.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000073&pid=S0120-0690200900010000300012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  13. Navarange M, Game L, Fowler D, Wadekar V, Banks   H, et al. MiMiR: a comprehensive solution for storage,   annotation and exchange of microarray data. BMC   Bioinformatics 2005; 6: 268-277.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000074&pid=S0120-0690200900010000300013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 14. Raguin O, Gruaz-Guyon A, Barbet J. Equilibrium   expert: an add-in to Microsoft Excel for multiple binding   equilibrium simulations and parameter estimations. Anal.   Biochem. 2002; 310: 1-14.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000075&pid=S0120-0690200900010000300014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">  15. Saeed AI, Sharov V, White J, Li J, Liang W, et al. TM4: a   free, open-source system for microarray data management   and analysis. Biotechniques 2004; 34: 374-378.</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000076&pid=S0120-0690200900010000300015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body><back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Barrett]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
<name>
<surname><![CDATA[Suzek]]></surname>
<given-names><![CDATA[TO]]></given-names>
</name>
<name>
<surname><![CDATA[Troup]]></surname>
<given-names><![CDATA[DB]]></given-names>
</name>
<name>
<surname><![CDATA[Wilhite]]></surname>
<given-names><![CDATA[SE]]></given-names>
</name>
<name>
<surname><![CDATA[Ngau]]></surname>
<given-names><![CDATA[WC]]></given-names>
</name>
<name>
<surname><![CDATA[Ledoux]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[NCBI GEO: mining millions of expression profiles-database and tools]]></article-title>
<source><![CDATA[Nucleic Acids Res]]></source>
<year>2005</year>
<volume>33</volume>
<page-range>D562-D566</page-range></nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Brown]]></surname>
<given-names><![CDATA[AM]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A non-linear regression analysis program for describing electrophysiological data with multiple functions using Microsoft Excel, Comput]]></article-title>
<source><![CDATA[Meth. Prog. Biomed]]></source>
<year>2006</year>
<volume>82</volume>
<page-range>51-57</page-range></nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Dansirikul]]></surname>
<given-names><![CDATA[C]]></given-names>
</name>
<name>
<surname><![CDATA[Choi]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Duffull]]></surname>
<given-names><![CDATA[SB]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Estimation of pharmacokinetic parameters from non-compartmental variables using Microsoft Excel]]></article-title>
<source><![CDATA[Comput. Biol. Med]]></source>
<year>2005</year>
<volume>35</volume>
<page-range>389-403</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Gentleman]]></surname>
<given-names><![CDATA[RC]]></given-names>
</name>
<name>
<surname><![CDATA[Carey]]></surname>
<given-names><![CDATA[VJ]]></given-names>
</name>
<name>
<surname><![CDATA[Bates]]></surname>
<given-names><![CDATA[DM]]></given-names>
</name>
<name>
<surname><![CDATA[Bolstad]]></surname>
<given-names><![CDATA[B]]></given-names>
</name>
<name>
<surname><![CDATA[Dettling]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bioconductor: open software development for computational biology and bioinformatics]]></article-title>
<source><![CDATA[Genome Biol]]></source>
<year>2004</year>
<page-range>R80</page-range></nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Heyer]]></surname>
<given-names><![CDATA[LJ]]></given-names>
</name>
<name>
<surname><![CDATA[Moskowitz]]></surname>
<given-names><![CDATA[DZ]]></given-names>
</name>
<name>
<surname><![CDATA[Abele]]></surname>
<given-names><![CDATA[JA]]></given-names>
</name>
<name>
<surname><![CDATA[Karnik]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
<name>
<surname><![CDATA[Choi]]></surname>
<given-names><![CDATA[D]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[MAGIC Tool: integrated microarray data analysis]]></article-title>
<source><![CDATA[Bioinformatics]]></source>
<year>2005</year>
<volume>21</volume>
<page-range>2114-2115</page-range></nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Hulshizer]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
<name>
<surname><![CDATA[Blalock]]></surname>
<given-names><![CDATA[EM]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Post hoc pattern matching: assigning significance to statistically defined expression pattern in single channel microarray data]]></article-title>
<source><![CDATA[BMC Bioinformatics]]></source>
<year>2007</year>
<volume>8</volume>
<page-range>240</page-range></nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Jo]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Gieske]]></surname>
<given-names><![CDATA[MC]]></given-names>
</name>
<name>
<surname><![CDATA[Payne]]></surname>
<given-names><![CDATA[CE]]></given-names>
</name>
<name>
<surname><![CDATA[Wheeler-Price]]></surname>
<given-names><![CDATA[SE]]></given-names>
</name>
<name>
<surname><![CDATA[Gieske]]></surname>
<given-names><![CDATA[JB]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Development and application of a rat ovarian gene expression database (rOGED)]]></article-title>
<source><![CDATA[Endocrinol]]></source>
<year>2004</year>
<volume>145</volume>
<page-range>5384-5396</page-range></nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Khan]]></surname>
<given-names><![CDATA[HA]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[ArraySolver: an algorithm for color-coded graphical display and Wilcoxon signed-rank statistics for comparing microarray gene expression data]]></article-title>
<source><![CDATA[Comput Func Genom]]></source>
<year>2004</year>
<volume>5</volume>
<page-range>39-47</page-range></nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Lash]]></surname>
<given-names><![CDATA[AE]]></given-names>
</name>
<name>
<surname><![CDATA[Tolstoshev]]></surname>
<given-names><![CDATA[CM]]></given-names>
</name>
<name>
<surname><![CDATA[Wagner]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
<name>
<surname><![CDATA[Schuler]]></surname>
<given-names><![CDATA[GD]]></given-names>
</name>
<name>
<surname><![CDATA[Strausberg]]></surname>
<given-names><![CDATA[RL]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[SAGEmap: a public gene expression resource]]></article-title>
<source><![CDATA[Genome Res]]></source>
<year>2000</year>
<volume>10</volume>
<page-range>1051-1060</page-range></nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Lindemann]]></surname>
<given-names><![CDATA[MD]]></given-names>
</name>
<name>
<surname><![CDATA[Kim]]></surname>
<given-names><![CDATA[BG]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Technical note: A model to estimate individual feed intake of swine in group feeding]]></article-title>
<source><![CDATA[J. Anim. Sci]]></source>
<year>2007</year>
<volume>85</volume>
<page-range>972-975</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Liu]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
<name>
<surname><![CDATA[Tarima]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
<name>
<surname><![CDATA[Borders]]></surname>
<given-names><![CDATA[AS]]></given-names>
</name>
<name>
<surname><![CDATA[Getchell]]></surname>
<given-names><![CDATA[TV]]></given-names>
</name>
<name>
<surname><![CDATA[Getchell]]></surname>
<given-names><![CDATA[ML]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Quadratic regression analysis for gene discovery and pattern recognition for non-cyclic short time-course microarray experiments]]></article-title>
<source><![CDATA[BMC Bioinformatics]]></source>
<year>2005</year>
<volume>6</volume>
<page-range>106</page-range></nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="book">
<person-group person-group-type="author">
<name>
<surname><![CDATA[McMullen]]></surname>
<given-names><![CDATA[CA]]></given-names>
</name>
<name>
<surname><![CDATA[Moylan]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Reid]]></surname>
<given-names><![CDATA[MB]]></given-names>
</name>
<name>
<surname><![CDATA[Andrade]]></surname>
<given-names><![CDATA[FH]]></given-names>
</name>
</person-group>
<source><![CDATA[C2C12 transcriptome changes in response to hydrogen peroxide]]></source>
<year>2005</year>
<publisher-name><![CDATA[NCBI GEO]]></publisher-name>
</nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Navarange]]></surname>
<given-names><![CDATA[M]]></given-names>
</name>
<name>
<surname><![CDATA[Game]]></surname>
<given-names><![CDATA[L]]></given-names>
</name>
<name>
<surname><![CDATA[Fowler]]></surname>
<given-names><![CDATA[D]]></given-names>
</name>
<name>
<surname><![CDATA[Wadekar]]></surname>
<given-names><![CDATA[V]]></given-names>
</name>
<name>
<surname><![CDATA[Banks]]></surname>
<given-names><![CDATA[H]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[MiMiR: a comprehensive solution for storage, annotation and exchange of microarray data]]></article-title>
<source><![CDATA[BMC Bioinformatics]]></source>
<year>2005</year>
<volume>6</volume>
<page-range>268-277</page-range></nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Raguin]]></surname>
<given-names><![CDATA[O]]></given-names>
</name>
<name>
<surname><![CDATA[Gruaz-Guyon]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
<name>
<surname><![CDATA[Barbet]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Equilibrium expert: an add-in to Microsoft Excel for multiple binding equilibrium simulations and parameter estimations]]></article-title>
<source><![CDATA[Anal. Biochem]]></source>
<year>2002</year>
<volume>310</volume>
<page-range>1-14</page-range></nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Saeed]]></surname>
<given-names><![CDATA[AI]]></given-names>
</name>
<name>
<surname><![CDATA[Sharov]]></surname>
<given-names><![CDATA[V]]></given-names>
</name>
<name>
<surname><![CDATA[White]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Li]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Liang]]></surname>
<given-names><![CDATA[W]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[TM4: a free, open-source system for microarray data management and analysis]]></article-title>
<source><![CDATA[Biotechniques]]></source>
<year>2004</year>
<volume>34</volume>
<page-range>374-378</page-range></nlm-citation>
</ref>
</ref-list>
</back>
</article>