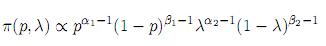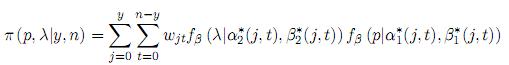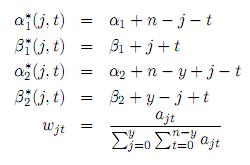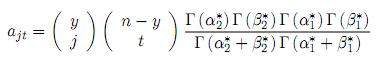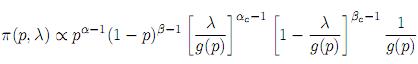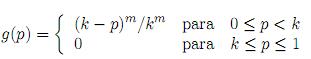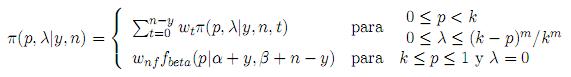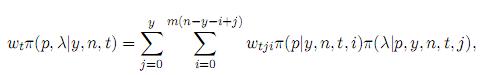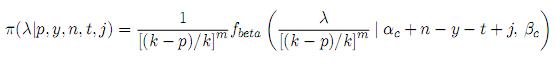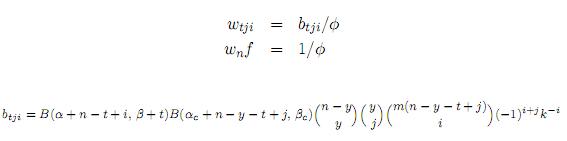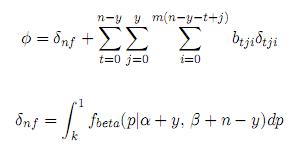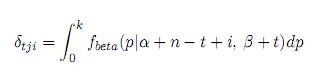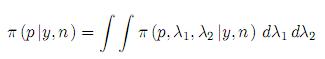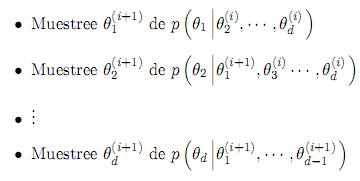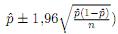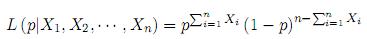
<?xml version="1.0" encoding="ISO-8859-1"?><article xmlns:mml="http://www.w3.org/1998/Math/MathML" xmlns:xlink="http://www.w3.org/1999/xlink" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance">
<front>
<journal-meta>
<journal-id>1794-9165</journal-id>
<journal-title><![CDATA[Ingeniería y Ciencia]]></journal-title>
<abbrev-journal-title><![CDATA[ing.cienc.]]></abbrev-journal-title>
<issn>1794-9165</issn>
<publisher>
<publisher-name><![CDATA[Escuela de Ciencias y Humanidades y Escuela de Ingeniería de la Universidad EAFIT]]></publisher-name>
</publisher>
</journal-meta>
<article-meta>
<article-id>S1794-91652012000100008</article-id>
<title-group>
<article-title xml:lang="es"><![CDATA[Estimación bayesiana de una proporción bajo error de estimación asimétrico]]></article-title>
<article-title xml:lang="en"><![CDATA[Bayesian estimation of a proportion under an asymmetric observation error]]></article-title>
<article-title xml:lang="pt"><![CDATA[Estimação bayesiana de um erro de estimação em relação assimétrica]]></article-title>
</title-group>
<contrib-group>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Correa Morales]]></surname>
<given-names><![CDATA[Juan Carlos]]></given-names>
</name>
<xref ref-type="aff" rid="A01"/>
</contrib>
<contrib contrib-type="author">
<name>
<surname><![CDATA[Salazar Uribe]]></surname>
<given-names><![CDATA[Juan Carlos]]></given-names>
</name>
<xref ref-type="aff" rid="A02"/>
</contrib>
</contrib-group>
<aff id="A01">
<institution><![CDATA[,Universidad Nacional de Colombia  ]]></institution>
<addr-line><![CDATA[Medellín ]]></addr-line>
<country>Colombia</country>
</aff>
<aff id="A02">
<institution><![CDATA[,Universidad Nacional de Colombia  ]]></institution>
<addr-line><![CDATA[Medellín ]]></addr-line>
<country>Colombia</country>
</aff>
<pub-date pub-type="pub">
<day>00</day>
<month>06</month>
<year>2012</year>
</pub-date>
<pub-date pub-type="epub">
<day>00</day>
<month>06</month>
<year>2012</year>
</pub-date>
<volume>8</volume>
<numero>15</numero>
<fpage>157</fpage>
<lpage>170</lpage>
<copyright-statement/>
<copyright-year/>
<self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_arttext&amp;pid=S1794-91652012000100008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_abstract&amp;pid=S1794-91652012000100008&amp;lng=en&amp;nrm=iso"></self-uri><self-uri xlink:href="http://www.scielo.org.co/scielo.php?script=sci_pdf&amp;pid=S1794-91652012000100008&amp;lng=en&amp;nrm=iso"></self-uri><abstract abstract-type="short" xml:lang="es"><p><![CDATA[El proceso de estimación de una proporción relacionada con una pregunta que puede ser altamente sensible para el encuestado, puede generar respuestas que no necesariamente coinciden con la realidad. Para reducir la probabilidad de respuestas falsas a este tipo de preguntas algunos autores han propuesto técnicas de respuesta aleatorizada asumiendo un error de observación asimétrico. En este artículo se presenta una generalización al caso donde se asume un error simétrico lo cual puede ser un supuesto poco realista en la práctica. Se deduce la función de verosimilitud bajo el supuesto de error de estimación asimétrico. Con esto se pretende que en la práctica se cuente con un método alternativo para reducir la probabilidad de respuestas falsas. Asumiendo distribuciones a priori informativas se encuentra una expresión para la distribución posterior. Puesto que esta última no tiene una expresión cerrada es necesario usar el muestreador de Gibbs en el proceso de estimación. Esta técnica se ilustra usando datos reales sobre consumo de drogas recolectados por la Oficina de Bienestar de la Universidad Nacional de Colombia, Sede Medellín.]]></p></abstract>
<abstract abstract-type="short" xml:lang="en"><p><![CDATA[The process of estimating a proportion that is associated with a sensitive question can yield responses that are not necessarily according to the reality. To reduce the probability o false response to this kind of sensitive questions some authors have proposed techniques of randomized response assuming a symmetric observation error. In this paper we present a generalization of the case where a symmetric error is assumed since this assumption could be unrealistic in practice. Under the assumption of an assymetric error the likelihood function is built. By doing this we intend that in practice the final user has an alternative method to reduce the probability of false response. Assuming informative a priori distributions an expresion for the posterior distribution is found. Since this posterior distribution does not have a closed mathematical expression, it is neccesary to use the Gibbs sampler to carry out the estimation process. This technique is illustrated using real data about drug consumptions that were collected by the Oficina de Bienestar from the Universidad Nacional de Colombia at Medellín.]]></p></abstract>
<abstract abstract-type="short" xml:lang="pt"><p><![CDATA[O processo da estimação de uma proporção relacionada a uma questão que pode ser muito sensível para o entrevistado, pode gerar respostas que não coincidem necessariamente com a realidade. Para reduzir a probabilidade de respostas falsas a estas questões, alguns autores propuseram técnicas de resposta aleatórias, supondo um erro de observação assimétrico. Neste artigo apresentamos uma generalização do caso onde um erro simétrico é considerado, o qual pode ser uma hipótese irrealista na prática. Logo, deduzimos a função de verossimilhança sob a hipótese de erro de estimação assimétrico, a qual é usada na prática como um método alternativo para reduzir a probabilidade de respostas falsas. Assumindo a prioris informativas é achada uma expressão para a distribuição a posteriori. Já que o último não tem uma expressão fechada é necessário utilizar a amostragem de Gibbs no processo de estimação. Esta técnica é ilustrada com dados reais coletados no uso de drogas pelo Gabinete de Ação Social da Universidade Nacional da Colômbia, Medellín.]]></p></abstract>
<kwd-group>
<kwd lng="es"><![CDATA[Estimación bayesiana]]></kwd>
<kwd lng="es"><![CDATA[distribución binomial]]></kwd>
<kwd lng="es"><![CDATA[probabilidad de respuesta falsa]]></kwd>
<kwd lng="es"><![CDATA[sustancias sicoactivas]]></kwd>
<kwd lng="en"><![CDATA[Bayesian estimation]]></kwd>
<kwd lng="en"><![CDATA[Binomial distribution]]></kwd>
<kwd lng="en"><![CDATA[Probability of false response]]></kwd>
<kwd lng="en"><![CDATA[psychoactive drugs]]></kwd>
<kwd lng="pt"><![CDATA[Estimação bayesiana]]></kwd>
<kwd lng="pt"><![CDATA[distribuição binomial]]></kwd>
<kwd lng="pt"><![CDATA[probabilidade de resposta falsa]]></kwd>
<kwd lng="pt"><![CDATA[substâncias psicoativas]]></kwd>
</kwd-group>
</article-meta>
</front><body><![CDATA[ <p align="right"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>ART&Iacute;CULO ORIGINAL</b></font></p>     <p align="center">&nbsp;</p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="4"><b>Estimaci&oacute;n  bayesiana de una proporci&oacute;n bajo error de estimaci&oacute;n  asim&eacute;trico </b></font></p>     <p align="center">&nbsp;</p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Bayesian estimation  of a proportion under an asymmetric observation error</b></font></p>     <p align="center">&nbsp;</p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b> Estima&ccedil;&atilde;o bayesiana  de um erro de estima&ccedil;&atilde;o em rela&ccedil;&atilde;o assim&eacute;trica</b></font></p>     <p align="center">&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Juan Carlos Correa  Morales<sup>1</sup>, Juan Carlos Salazar  Uribe<sup>2</sup> </font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><sup>1</sup> Doctor  en Estad&iacute;stica, <a href="mailto:jccorrea@unal.edu.co">jccorrea@unal.edu.co</a>, profesor, Universidad Nacional de Colombia, Medell&iacute;n Medell&iacute;n, Medell&iacute;n-Colombia.</font></p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> <sup>2</sup> Doctor  en Estad&iacute;stica, <a href="mailto:jcsalaza@unal.edu.co">jcsalaza@unal.edu.co</a>, profesor, Universidad Nacional de   Colombia, Medell&iacute;n-Medell&iacute;n, Medell&iacute;n-Colombia.</font></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Recepci&oacute;n:  02-may-2011. Modificaci&oacute;n: 10-may-2012. Aceptaci&oacute;n: 16-may-2012 </font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Se  aceptan comentarios y/o discusiones al art&iacute;culo</font></p>     <p>&nbsp;</p> <hr size="1" />     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Resumen</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">   El  proceso de estimaci&oacute;n de una proporci&oacute;n relacionada con una pregunta que   puede  ser altamente sensible para el encuestado, puede generar respuestas que   no  necesariamente coinciden con la realidad. Para reducir la probabilidad de   respuestas  falsas a este tipo de preguntas algunos autores han propuesto t&eacute;cnicas  de respuesta aleatorizada asumiendo un error de observaci&oacute;n asim&eacute;trico.   En  este art&iacute;culo se presenta una generalizaci&oacute;n al caso donde se asume un error   sim&eacute;trico  lo cual puede ser un supuesto poco realista en la pr&aacute;ctica. Se deduce   la  funci&oacute;n de verosimilitud bajo el supuesto de error de estimaci&oacute;n asim&eacute;trico.   Con  esto se pretende que en la pr&aacute;ctica se cuente con un m&eacute;todo alternativo   para  reducir la probabilidad de respuestas falsas. Asumiendo distribuciones   a  priori informativas se encuentra una expresi&oacute;n para la distribuci&oacute;n posterior.  Puesto que esta &uacute;ltima no tiene una expresi&oacute;n cerrada es necesario usar   el  muestreador de Gibbs en el proceso de estimaci&oacute;n. Esta t&eacute;cnica se ilustra   usando  datos reales sobre consumo de drogas recolectados por la Oficina de   Bienestar  de la Universidad Nacional de Colombia, Sede Medell&iacute;n.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Palabras  claves:</b> Estimaci&oacute;n bayesiana, distribuci&oacute;n binomial, probabilidad de  respuesta falsa, sustancias sicoactivas.</font></p> <hr size="1" />     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Abstract</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">   The  process of estimating a proportion that is associated with a sensitive   question  can yield responses that are not necessarily according to the reality.   To  reduce the probability o false response to this kind of sensitive questions   some  authors have proposed techniques of randomized response assuming a   symmetric  observation error. In this paper we present a generalization of the   case  where a symmetric error is assumed since this assumption could be unrealistic  in practice. Under the assumption of an assymetric error the likelihood   function  is built. By doing this we intend that in practice the final user has   an  alternative method to reduce the probability of false response. Assuming   informative  a priori distributions an expresion for the posterior distribution is   found.  Since this posterior distribution does not have a closed mathematical   expression,  it is neccesary to use the Gibbs sampler to carry out the estimation   process.  This technique is illustrated using real data about drug consumptions   that  were collected by the Oficina de Bienestar from the Universidad Nacional   de  Colombia at Medell&iacute;n.</font></p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Key words:</b> Bayesian  estimation, Binomial distribution, Probability of false response,  psychoactive drugs.</font></p> <hr size="1" />     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Resumo </b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">O  processo da estima&ccedil;&atilde;o de uma propor&ccedil;&atilde;o relacionada a uma quest&atilde;o que   pode  ser muito sens&iacute;vel para o entrevistado, pode gerar respostas que n&atilde;o   coincidem necessariamente com a realidade. Para reduzir a probabilidade   de  respostas falsas a estas quest&otilde;es, alguns autores propuseram t&eacute;cnicas de   resposta  aleat&oacute;rias, supondo um erro de observa&ccedil;&atilde;o assim&eacute;trico. Neste artigo   apresentamos  uma generaliza&ccedil;&atilde;o do caso onde um erro sim&eacute;trico &eacute; considerado,   o  qual pode ser uma hip&oacute;tese irrealista na pr&aacute;tica. Logo, deduzimos a fun&ccedil;&atilde;o   de  verossimilhan&ccedil;a sob a hip&oacute;tese de erro de estima&ccedil;&atilde;o assim&eacute;trico, a qual &eacute;   usada  na pr&aacute;tica como um m&eacute;todo alternativo para reduzir a probabilidade   de  respostas falsas. Assumindo a prioris informativas &eacute; achada uma express&atilde;o   para  a distribui&ccedil;&atilde;o a posteriori. J&aacute; que o &uacute;ltimo n&atilde;o tem uma express&atilde;o   fechada  &eacute; necess&aacute;rio utilizar a amostragem de Gibbs no processo de estima&ccedil;&atilde;o.   Esta  t&eacute;cnica &eacute; ilustrada com dados reais coletados no uso de drogas pelo   Gabinete  de A&ccedil;&atilde;o Social da Universidade Nacional da Col&ocirc;mbia, Medell&iacute;n.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">   <b>Palavras chaves:</b> Estima&ccedil;&atilde;o  bayesiana, distribui&ccedil;&atilde;o binomial, probabilidade   de  resposta falsa, subst&acirc;ncias psicoativas.</font></p> <hr size="1" />     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>1 Introducci&oacute;n</b></font></p>      <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Cuando se trata de  estimar una proporci&oacute;n no es poco com&uacute;n tener registros   equivocados en la  muestra Bernoulli. Esto puede ocurrir por muchas razones.   Por ejemplo, en una  encuesta una persona puede responder de manera intencional  una pregunta sensible sobre consumo de drogas, de homosexualidad, o   sobre  pol&iacute;tica. En otras situaciones la persona puede no recordar un evento   pasado. Para algunas  situaciones donde el sujeto encuestado puede sentirse   comprometido o  expuesto por la respuesta a una pregunta sensible y donde se   pueda presentar la  situaci&oacute;n de dar una respuesta falsa, Warner &#91;1, 2&#93; propuso   un  procedimiento conocido como el de la respuesta aleatorizada. Este procedimiento  tambi&eacute;n ha sido estudiado por otros autores tales como, Greenberg   &#91;3&#93;,  Lamb y Stem &#91;4&#93;, Campbell &#91;5&#93;,  Tracy y Fox &#91;6&#93;, Miller &#91;7&#93;,  Bourke y Dallenius &#91;8&#93;, &#91;9&#93;, &#91;10, 11&#93;, &#91;12&#93;. Por otra parte, Winkler y Gaba &#91;13&#93; proponen un   m&eacute;todo de  estimaci&oacute;n bayesiana de la proporci&oacute;n verdadera basado en datos   que  pudieran haber sido recolectados usando el m&eacute;todo de respuesta aleatorizada. Este m&eacute;todo  asume, entre otros supuestos, que el error de observaci&oacute;n   es  sim&eacute;trico lo cual puede no ser un supuesto realista en la pr&aacute;ctica. Por ejemplo, es m&aacute;s  frecuente que una persona niegue tener una cierta caracter&iacute;stica   cuando  en realidad la tiene a que una persona acepte tenerla solamente con   el fin  de despistar o burlar al encuestador, es decir a una pregunta tal como   &iquest;Consume  usted alguna sustancia alucin&oacute;gena? una persona que en realidad   lo hace tiene una  alta probabilidad de negarlo mientras que una persona que   en realidad no usa  este tipo de sustancias podr&iacute;a responder afirmativamente   pero no parece  razonable asumir que ambas probabilidades sean iguales. Por   esta raz&oacute;n, para  estimar la proporci&oacute;n, parece m&aacute;s conveniente asumir que el   error de observaci&oacute;n  es asim&eacute;trico. Ahora, puesto que tratar de averiguar a   partir  de la muestra quienes respondieron correcta o incorrectamente no parece ser una tarea  f&aacute;cil, asumir distribuciones a priori informativas para estas   tasas  de falsa respuesta o clasificaci&oacute;n puede ayudar a modelar esta incertidumbre.  El problema de la clasificaci&oacute;n err&oacute;nea es un problema que no pierde   vigencia  como se puede evidenciar en la literatuta reciente (Stamey et al. &#91;14&#93;, Boese  et al. &#91;15&#93;, Lee y Byun &#91;16&#93; y Rahardja y Zhao &#91;17&#93;)  donde se aborda el problema desde distintas  perspectivas y escenarios muestrales diversos.</font></p>      <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">El prop&oacute;sito de este  trabajo es mostrar una estrategia de estimaci&oacute;n bayesiana de la  proporci&oacute;n verdadera asumiendo que el error de observaci&oacute;n no es sim&eacute;trico. Para  alcanzar este objetivo se exponen primero aspectos relacionados  con el trabajo de Winkler y Gaba. Luego se generaliza este trabajo para permitir errores de  observaci&oacute;n asim&eacute;tricos. Finalmente, se ilustra la t&eacute;cnica usando datos reales  sobre consumo de drogas en la Universidad Nacional de Colombia, Sede  Medell&iacute;n.</font></p>     <p>&nbsp;</p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>2 Metodolog&iacute;a</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">En esta secci&oacute;n se  detalla la metodolog&iacute;a de an&aacute;lisis estad&iacute;stico propuesta   para el problema de  la obtenci&oacute;n de la proporci&oacute;n bajo el supuesto de error   asim&eacute;trico. Esta  metodolog&iacute;a no se ha presentado en la literatura y constituye   un aporte original de  este trabajo.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>2.1 El m&eacute;todo de  respuesta aleatorizada</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">El m&eacute;todo de  respuesta aleatorizada es un m&eacute;todo que se usa en encuestas   y entrevistas  estructuradas. Fue propuesto en primera instancia por Stanley   L. Warner &#91;1&#93;.  Este m&eacute;todo permite al encuestado responder a preguntas   sensibles (por  ejemplo comportamiento criminal o sexualidad) al tiempo que   se  mantiene la confidencialidad. La pregunta sensible se dicotomiza y el azar   decide, sin el  conocimiento del encuestador, cual de las dos alternativas se   va a responder de  manera honesta. Por ejemplo, se le pide al encuestado que   antes de responder  lance un dado y que responda una de las dos alternativas   solo  si obtiene un 6, en caso contrario debe responder la otra alternativa. El   encuestador obtiene  un Si o un No sin saber a cual de las dos alternativas se   le asign&oacute; una de  estas respuestas.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Si se denota por <i>p</i> la  verdadera probabilidad que se trata de estimar y si     <i>X</i><sub>1</sub>, <i>X</i><sub>2</sub>, &middot; &middot; &middot; , <i>X<sub>n</sub></i> es una muestra  aleatoria de una Bernoulli(<i>p</i>), la verosimilitud de la muestra estar&aacute;  dada por:</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g1.jpg"></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">y si <i>&pi;</i>(<i>p</i>) denota la  distribuci&oacute;n a priori, entonces la distribuci&oacute;n posterior ser&aacute; <i>&pi;</i> (<i>p</i>|<i>X</i><sub>1</sub>, <i>X</i><sub>2</sub>, &middot; &middot; &middot; , <i>X<sub>n</sub></i>) <img src="/img/revistas/ince/v8n15/v8n15a08g19.jpg" /> <i>L</i> (<i>p</i>|<i>X</i><sub>1</sub>, <i>X</i><sub>2</sub>, &middot; &middot; &middot; , <i>X<sub>n</sub></i>) <i>&pi;</i>(<i>p</i>). Es com&uacute;n seleccionar como a priori una  distribuci&oacute;n conjugada, que en este caso es una distribuci&oacute;n beta,  digamos <i>Beta</i> (<i>&alpha;</i>, <i>&beta;</i>), lo cual nos lleva a una posterior de la misma fami</font><font face="Verdana, Arial, Helvetica, sans-serif" size="2">lia, <i>Beta</i> (&alpha; + <img src="/img/revistas/ince/v8n15/v8n15a08g2.jpg" /> <i>Xi</i>, &beta;  + <i>n</i> - <img src="/img/revistas/ince/v8n15/v8n15a08g2.jpg" /> <i>Xi</i>).  En esta situaci&oacute;n es f&aacute;cil realizar </font><font face="Verdana, Arial, Helvetica, sans-serif" size="2">inferencias  acerca de <i>p</i>. </font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"></font><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Si &lambda;  denota la probabilidad de que un sujeto est&eacute; mal clasificado, entonces la verosimilitud  ser&aacute;:</font></p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><i>L</i>(<i>p</i>, &lambda;|<i>y, n</i>) = &#91;<i>p</i>(1 -  &lambda;) + (1 - <i>p</i>)&lambda;&#93;<sup>y</sup>&#91;<i>p</i>&lambda; + (1 - <i>p</i>)(1 - &lambda;)&#93;<i><sup>n-y</sup></i></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Winkler  y Gaba (1990) proponen la siguiente distribuci&oacute;n a priori para <i>p</i> y &lambda;</font></p>     ]]></body>
<body><![CDATA[<p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g3.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">la cual es el producto de dos beta. Ellos asumieron independencia  entre <i>p</i> y &lambda;,  lo cual puede no ser realista en muchas situaciones, por ejemplo, una persona  puede responder positivamente si ha tenido una conducta antisocial que puede ser  practicada por una gran parte de la poblaci&oacute;n, por ejemplo pasarse un sem&aacute;foro  en rojo. Bajo este modelo ellos llegan a la siguiente distribuci&oacute;n  posterior</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g4.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g5.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">con</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g6.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Esta es una mezcla de  productos de distribuciones beta.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">   Gaba &#91;18&#93; considera  la estimaci&oacute;n en un proceso de Bernoulli con error,   pero  asume dependencia entre el nivel del error y la proporci&oacute;n de inter&eacute;s. La   densidad conjunta a  priori de <i>p</i> y &lambda; puede expresarse como</font></p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><i>&pi;</i>(<i>p</i>, &lambda;) = <i>&pi;</i>(<i>p</i>)<i>&pi;</i>(&lambda;|<i>p</i>)</font></p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Gaba  seleccion&oacute; una beta con par&aacute;metros <i>&alpha;</i> y <i>&beta;</i> para la distribuci&oacute;n marginal a priori de <i>p</i> y  asumi&oacute; que el par&aacute;metro de ruido es modelado como</font></p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="2">&lambda; = <i>cg</i>(<i>p</i>),</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde  0 &le; &lambda; &le; 1, <i>g</i>(<i>p</i>) es una funci&oacute;n no creciente de <i>p</i> (lineal o no) tal que 0 &le;     <i>g</i>(<i>p</i>)  &le; 1, con <i>g</i>(0) = 1 y <i>c</i> es una variable aleatoria en &#91;0, 1&#93;. La distribuci&oacute;n de     <i>c</i> la  model&oacute; como una beta con par&aacute;metros <i>&alpha;<sub>c</sub></i> y <i>&beta;<sub>c</sub></i>. La  distribuci&oacute;n de &lambda;/<i>g</i>(<i>p</i>) dado  <i>p</i> sigue una <i>Beta</i>(<i>&alpha;<sub>c</sub></i>, <i>&beta;<sub>c</sub></i>). Por lo tanto la distribuci&oacute;n de &lambda; condicionada en <i>p</i> es una beta  re-escalada en el intervalo &#91;0, <i>g</i>(<i>p</i>)&#93;. Si <i>g</i>(<i>p</i>)  = 0, esta beta re-escalada  es degenerada en cero, o sea <i>P</i>(&lambda; = 0|<i>p</i>) = 1. La a priori conjunta de <i>p</i> y &lambda; es entonces </font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g7.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde 0 &le; <i>p</i> &le; 1, 0 &le; &lambda;  &le; <i>g</i>(<i>p</i>) y 0 &lt; <i>g</i>(<i>p</i>) &le; 1. Gaba propone trabajar con <i>g</i>(<i>p</i>) seleccionada de</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g8.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde <i>k</i> &gt; 0 y <i>m</i> &ge;  0.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">La distribuci&oacute;n  posterior ser&aacute;:</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g9.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde</font></p>     ]]></body>
<body><![CDATA[<p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g10.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">donde <i>&pi;</i>(<i>p</i>|<i>y, n, t, i</i>) es una distribuci&oacute;n beta con par&aacute;metros <i>&alpha;</i> + <i>n</i> - <i>t</i> + <i>i</i> y <i>&beta;</i> + <i>t</i>;</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g11.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">y</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g12.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">con &phi; como una constante de normalizaci&oacute;n dada por</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g13.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">y</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g14.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>2.2 Estimaci&oacute;n asumiendo  error de observaci&oacute;n asim&eacute;trico</b></font></p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Ahora, si el sujeto  encuestado tiene una probabilidad diferente de ser mal   clasificado  cuando es un "&eacute;xito", llamela &lambda;<sub>1</sub>,  que cuando es un "fracaso", la   cual se denotar&aacute; &lambda;<sub>2</sub>, la verosimilitud  ser&aacute; entonces:</font></p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><i>L</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>|<i>y</i>, <i>n</i> ) = &#91;<i>p</i>(1 - &lambda;<sub>1</sub>) + (1 - <i>p</i>)&lambda;<sub>2</sub>&#93;<i><sup>y </sup></i>&#91;1 - <i>p</i>(1 - &lambda;<sub>1</sub>) + (1 - <i>p</i>)&lambda;<sub>2</sub>&#93;<i><sup>n-y</sup></i></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Si <i>&pi;</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>)  denota la distribuci&oacute;n a priori, entonces la distribuci&oacute;n posterior ser&aacute;:</font></p>     <p align="center"><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><i>&pi;</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>|<i>y</i>, <i>n</i> ) <img src="/img/revistas/ince/v8n15/v8n15a08g19.jpg" /> <i>L</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>|<i>y</i>, <i>n</i> ) <i>&pi;</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>)</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Como  el par&aacute;metro de inter&eacute;s es <i>p</i>, se debe calcular la distribuci&oacute;n marginal. Esta se halla como:</font></p>     <p align="center"><img src="/img/revistas/ince/v8n15/v8n15a08g15.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Asumiendo  independencia, <i>&pi;</i> (<i>p</i>, &lambda;<sub>1</sub>, &lambda;<sub>2</sub>) = <i>&pi;<sub>p</sub></i>(<i>p</i>)<i>&pi;</i><sub>&lambda;<sub>1</sub></sub>(&lambda;<sub>1</sub>)<i>&pi;</i><sub>&lambda;<sub>2</sub></sub>(&lambda;<sub>2</sub>).  En este caso se puede asumir, por  ejemplo, que <i>p</i> se distribuye de acuerdo a una Beta(<i>&alpha;</i><sub>0</sub>,<i>&beta;</i><sub>0</sub>), y &lambda;<sub>1</sub> y &lambda;<sub>2</sub> de acuerdo a normales  truncadas en el intervalo (0, 1) con par&aacute;metros <i>&micro;</i><sub>0</sub> y <i>&sigma;</i><sub>0</sub>. Observe que la  distribuci&oacute;n posterior as&iacute; formulada no admite una soluci&oacute;n anal&iacute;tica  y por lo tanto se deben recurrir a m&eacute;todos num&eacute;ricos para poder muestrear  de ella. Una alternativa que ha probado ser efectiva es el muestreador Gibbs.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>2.3 El muestreador Gibbs</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">La soluci&oacute;n anal&iacute;tica  de problemas bayesianos es en muchos casos imposible.   De hecho, cuando las  distribuciones posteriores son de alta dimensi&oacute;n, las   soluciones anal&iacute;ticas  o las num&eacute;ricas com&uacute;nes no se pueden obtener. Esto ha   llevado al desarrollo  e implementaci&oacute;n de una metodolog&iacute;a conocida como   MCMC (Monte Carlo  Markov Chain), la cual ha permitido un desarrollo   significativo en la  soluci&oacute;n de problemas estad&iacute;sticos complejos. Los m&eacute;todos   MCMC son algoritmos  iterativos que se utilizan cuando el muestreo directo de  una distribuci&oacute;n de inter&eacute;s <i>&xi;</i> no es factible. En especial, la limitaci&oacute;n en  el uso  de distribuciones a priori se ha superado. Existen dos problemas mayores que rodean la  implementaci&oacute;n e inferencias de los m&eacute;todos MCMC.</font></p>     <blockquote>       ]]></body>
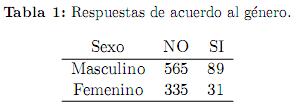
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">1. El primero tiene  que ver con la convergencia y</font></p>       <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">2.  el segundo con la dependencia entre las muestras de la distribuci&oacute;n     posterior.</font></p> </blockquote>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Uno  de los algoritmos m&aacute;s usado bajo esta metodolog&iacute;a es el denominado muestreador Gibbs  (Gibbs Sampler &#91;19&#93;)</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"><b>Muestreador Gibbs</b> Para  obtener una muestra de la distribuci&oacute;n conjunta <i>p</i>(<i>&theta;</i><sub>1</sub>, &middot; &middot; &middot; , <i>&theta;<sub>d</sub></i>) el muestreador  Gibbs &#91;19&#93; itera sobre este ciclo:</font></p>     <p><img src="/img/revistas/ince/v8n15/v8n15a08g16.jpg" /></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Este  proceso se detiene tan pronto la cadena de Markov alcanza la distribuci&oacute;n  l&iacute;mite. Sin embargo, en la pr&aacute;ctica esta convergencia puede ser muy lenta y el mayor  problema es saber si se ha logrado una convergencia razonable (esto se conoce  como un "burn-in"). Por lo tanto las muestras obtenidas hasta el punto de "burn-in"  son descartadas.</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Una ventaja de usar  m&eacute;todos Monte Carlo Markov Chain (MCMC) en el contexto del problema  que aqu&iacute; se trata es que se estima la probabilidad del evento de inter&eacute;s  corrigiendo la falsa respuesta que se puede obtener en ambos sentidos  (falsos positivos o falsos negativos). Ahora bien, como el problema se  aborda desde el punto de vista bayesiano, ya que se asumen distribuciones a priori  informativas generales sobre ambos casos, la presencia de tres par&aacute;metros de  inter&eacute;s puede ser complejo desde lo anal&iacute;tico porque no se impone una estructura  conjugada para la proporci&oacute;n de falsos positivos y falsos negativos. Es por  esto que resulta recomendable usar MCMC no solo por la disponibilidad del  software sino por la eficiencia demostrada del muestreador de Gibbs. La  principal desventaja de los m&eacute;todos MCMC, es que las muestras son  correlacionadas y en muchos casos no existe garant&iacute;a de que la cadena converja  a la distribuci&oacute;n l&iacute;mite. Otra alternativa al MCMC es la simulaci&oacute;n directa en la cual se  asumen muestras independientes.</font></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>3 Resultados</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">A continuaci&oacute;n se  presentan los resultados de aplicar la metodolog&iacute;a cl&aacute;sica,  la cual no tiene en cuenta la posibilidad de error en la respuesta, y la   bayesiana, la cual si  tiene en cuenta este error, para obtener la proporci&oacute;n.   Para esto se usar&aacute;n  datos recolectados por La Oficina de Bienestar de la Universidad  Nacional de Colombia, Sede Medell&iacute;n. En la encuesta que se realiza   entre estudiantes que  van a empezar su ciclo acad&eacute;mico a nivel de pregrado,   se  formulan preguntas sobre si el estudiante consume o no sustancias sicoactivas, tales como la  marihuana. Aunque el cuestionario es autoformulado, se   esperaba que algunos  estudiantes respondan falsamente a esta pregunta, unos   por temor o no  aceptaci&oacute;n de su situaci&oacute;n, en cuyo caso la respuesta es NO;   algunos otros  responden S&Iacute; como medio de burlar la pregunta. Para el a&ntilde;o 2008, primer semestre, se  registraron los siguientes resultados (ver <a href="#t1">Tabla 1</a>.):</font></p>     ]]></body>
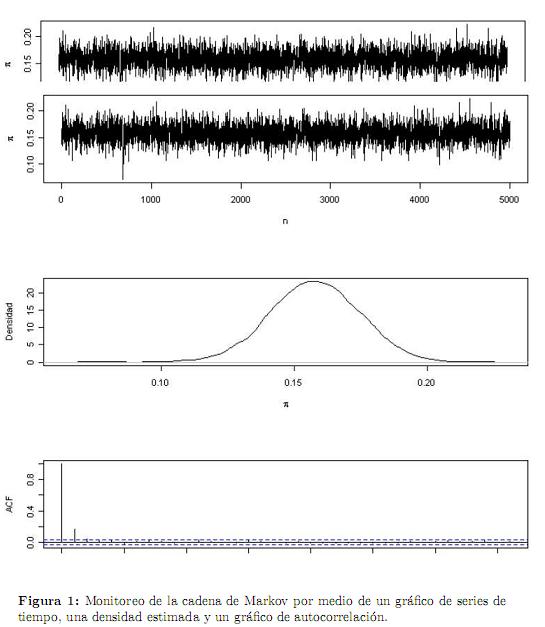
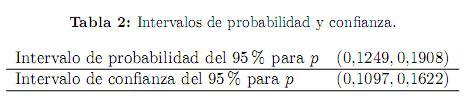
<body><![CDATA[<p align="center"><a name="t1"><img src="/img/revistas/ince/v8n15/v8n15a08t1.jpg" /></a></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Para obtener un  intervalo de probabilidad del 95 % para la proporci&oacute;n poblacional  de hombres consumidores de marihuana se implementar&aacute; el muestreador  Gibbs usando el software R. En particular se asumir&aacute; que la a priori para <i>p</i> es una  distribuci&oacute;n beta(10,50) y que las a priori para &lambda;<sub>1</sub> y &lambda;<sub>2</sub> son normales truncadas en el intervalo (0, 1) con par&aacute;metros <i>&micro;</i><sub>&lambda;<sub>1</sub></sub> = 0,8, <img src="/img/revistas/ince/v8n15/v8n15a08g17.jpg" />=  0,001,  <i>&micro;</i><sub>&lambda;<sub>2 </sub></sub>= 0,05 y <img src="/img/revistas/ince/v8n15/v8n15a08g17.jpg" /> = 0,001  (note que esta elecci&oacute;n de a prioris para &lambda;<sub>1</sub> y &lambda;<sub>2</sub> es m&aacute;s ventajosa que  asumirlas uniformes ya que las normales truncadas modelan  de mejor manera estas probabilidades). Por medio de una prueba de estacionaridad  se verific&oacute; que la cadena de Markov asociada a <i>p</i> converge a la distribuci&oacute;n l&iacute;mite  (valor-p&gt; 0.1).</font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Para  monitorear la convergencia, se obtuvieron los gr&aacute;ficos de la cadena, la  densidad y el de autocorrelaci&oacute;n, que muestran el buen comportamiento de la cadena (<a href="#f1">Figura 1</a>).</font></p>     <p align="center"><a name="f1"><img src="/img/revistas/ince/v8n15/v8n15a08f1.jpg" /></a></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">La <a href="#t2">Tabla 2</a> muestra el intervalo de probabilidad del  95 % para <i>p</i> y el intervalo de confianza  del 95 % para <i>p</i> (basado en el teorema de l&iacute;mite central, <img src="/img/revistas/ince/v8n15/v8n15a08g18.jpg" />. Se observa que    este &uacute;ltimo subestima la proporci&oacute;n poblacional    mientras que el primero reporta un rango m&aacute;s amplio debido a la naturaleza del  m&eacute;todo propuesto que incorpora el nivel de incertidumbre generada por las  distintas probabilidades de respuestas falsas.</font></p>     <p align="center"><a name="t2"><img src="/img/revistas/ince/v8n15/v8n15a08t2.jpg" /></a></p>     <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>4 Conclusiones</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">El manejo de la  respuesta falsa es un tema complejo entre los investigadores   de las ciencias  sociales y m&eacute;dicas, muchos de los cuales desconocen como enfrentarlo,  ya que t&eacute;cnicas como la respuesta aleatorizada tienen un alcance   muy  limitado por sus mismas caracter&iacute;sticas. En muchas circunstancias, el   investigador dispone  de informaci&oacute;n que le permite predecir la fiabilidad de   las  respuestas a preguntas comprometedoras. Este conocimiento se puede expresar en t&eacute;rminos  probabil&iacute;sticos con lo cual se pueden integrar al proceso de   estimaci&oacute;n de la  proporci&oacute;n. En este trabajo, se ha ilustrado como el m&eacute;todo   bayesiano permite  integrar estas incertidumbres en las estimaciones finales   en un tema altamente  sensible y en el cual los investigadores saben que se   presentan respuestas  falsas. Uno de los aportes principales es la deducci&oacute;n de   la funci&oacute;n de  verosimilitud la cual es una generalizaci&oacute;n de aquella propuesta   por  Winkler y Gaba &#91;13&#93;. El m&eacute;todo presentado en este trabajo no  se ha discutido en la  literatura y por esta razon constituye un aporte original al estado del arte.</font></p>      <p>&nbsp;</p>     ]]></body>
<body><![CDATA[<p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Agradecimientos</b></font></p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">Este trabajo fue  realizado con recursos del proyecto de investigaci&oacute;n 9201   de la Vicerrector&iacute;a  de Investigaci&oacute;n de la Universidad Nacional de Colombia,   c&oacute;digo DIME  20101007954. Los autores tambi&eacute;n agradecen a la Oficina de   Bienestar de la  Universidad Nacional de Colombia, Sede Medell&iacute;n por haber proporcionado los  datos para ilustrar este trabajo.</font></p>      <p>&nbsp;</p>     <p><font face="Verdana, Arial, Helvetica, sans-serif" size="3"><b>Referencias</b></font></p>     <!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">1. SL. Warner. <i>Randomized  response: a survey technique for eliminating evasive answer  bias</i>. Journal of the American Statistical Association, ISSN 0162-1459, <b>60</b>(309),  63-69 (1965). Referenciado en 159, 160</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000107&pid=S1794-9165201200010000800001&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 2.  SL. Warner. <i>The Linear Randomized Response Model</i>. Journal of the American   Statistical  Association, ISSN 0162-1459, <b>66</b>(336), 884-888 (1971). Referenciado   en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000108&pid=S1794-9165201200010000800002&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 3.  BG. Greenberg, Abdel-Latif A. Abul-Ela, WR. Simmons, DG. Horvitz. <i>The Unrelated  Question Randomized Response Model: Theoretical Framework</i>. Journal of   the  American Statistical Association, ISSN 0162-1459, <b>64</b>(326), 520-539 (1969).   Referenciado  en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000109&pid=S1794-9165201200010000800003&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 4.  CW. Lamb Jr, DE. Stem Jr. <i>An Empirical Validation of the Randomized Response  Technique</i>. Journal of Marketing Research, ISSN: 0022-2437, <b>15</b>(4), 616-621   (1978).  Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000110&pid=S1794-9165201200010000800004&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 5. A. Campbell. <i>Randomized  Response Technique</i>. Science, ISSN 0036-8075, <b>236</b>(4805),  1049 (1987). 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000111&pid=S1794-9165201200010000800005&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 6.  P. Tracy, JA Fox. <i>The Validity of Randomized Response for Sensitive Measurements</i>. American Sociological Review, ISSN 0003-1224, <b>46</b>(2), 187-200 (1981).   Referenciado  en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000112&pid=S1794-9165201200010000800006&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 7.  JD. Miller. <i>Complexities of the Randomized Response Solution</i>. American Sociological  Review, ISSN 0003-1224, <b>46</b>(6), 928-930 (1981). Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000113&pid=S1794-9165201200010000800007&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 8.  PD. Bourke, T. Dalenius. <i>Some New Ideas in the Realm of Randomized Inquiries</i>. International Statistical Review / Revue Internationale de Statistique, ISSN   1751-582, <b>44</b>(2), 219-221 (1976). Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000114&pid=S1794-9165201200010000800008&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 9.  BG. Greenberg, Abdel-Latif A. Abul-Ela, WR. Simmons, DG. Horvitz. <i>A Multi-Proportions  Randomized Response Model</i>. Journal of the American Statistical   Association,  ISSN 0162-1459, <b>62</b>(319), 990-1008 (1967). Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000115&pid=S1794-9165201200010000800009&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2">10.  NS. Mangat, R. Singh. <i>An Alternative Randomized Response Procedure</i>. Biometrika,  ISSN 0006-3444, <b>77</b>(2), 439-442 (1990). Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000116&pid=S1794-9165201200010000800010&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 11. NS. Mangat. <i>An  Improved Randomized Response Strategy</i>. Journal of the Royal  Statistical Society. Series B (Methodological), ISSN 1467-9868, <b>56</b>(1), 93-95   (1994).  Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000117&pid=S1794-9165201200010000800011&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 12.  A. O'Hagan. <i>Bayes Linear Estimators for Randomized Response Models</i>. Journal of the American Statistical Association, ISSN 0162-1459, <b>82</b>(398), 580-585   (1987).  Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000118&pid=S1794-9165201200010000800012&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 13.  RL. Winkler, A. Gaba. <i>Inference With Imperfect Sampling From Bernoulli Process</i>. in S. Geisser, J. Hodges, S.J. Press and A. Zellner, Eds., Bayesian and   Likelihood  Methods in Statistics and Econometrics: Essays in Honor of George   A.  Barnard, Amsterdam, North Holland, ISBN 0444883762, 303-317, 1990.   Referenciado  en 159, 168</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000119&pid=S1794-9165201200010000800013&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 14. JD. Stamey, JW. Seaman, DM. Young. <i>Bayesian analysis of complementary   Poisson  rate parameters with data subject to misclassification</i>. Journal of Statistical  Planning and Inference, ISSN 0378-3758, <b>134</b>, 36-48 (2005). Referenciado   en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000120&pid=S1794-9165201200010000800014&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 15.  DH. Boese, DH. Young, JD. Stamey. <i>Confidence intervals for a binomial parameter  base don binary data subject to false-positive misclassification</i>. Computational   Statistics  &amp; Data Analysis, ISSN 0167-9473, <b>50</b>, 3369-3385 (2006).   Referenciado  en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000121&pid=S1794-9165201200010000800015&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 16.  SC. Lee, JS. Byun. <i>Bayesian approach to obtain confidence intervals for binomial   proportion  in a double sampling scheme subject to false-positive misclassification</i>.   Journal of the Korean Statistical Society, ISSN 1226-3192, <b>37</b>, 393-403 (2008).   Referenciado  en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000122&pid=S1794-9165201200010000800016&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 17. D. Rahardja, YD. Zhao. <i>Bayesian  inference of a binomial porportion using   one  simple misclassified binary data</i>. Model Assisted Statistics and Applications,   ISSN  1574-1699, <b>7</b>(1), 17-22 (2012). Referenciado en 159</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000123&pid=S1794-9165201200010000800017&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 18.  A. Gaba. <i>Inferences with an Unknown Noise Level in a Bernoulli Process</i>. Managment Science, ISSN 0025-1909, <b>39</b>(10),  1227-1237 (1993). Referenciado en   162</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000124&pid=S1794-9165201200010000800018&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --><!-- ref --><p><font face="Verdana, Arial, Helvetica, sans-serif" size="2"> 19. G. Casella, Edward I. George. <i>Explaining  the Gibbs Sampler</i>. The American   Statistician,  ISSN 0003-1305 <b>46</b>(3), 167-174 (1992). Referenciado en 165</font>&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;&nbsp;[&#160;<a href="javascript:void(0);" onclick="javascript: window.open('/scielo.php?script=sci_nlinks&ref=000125&pid=S1794-9165201200010000800019&lng=','','width=640,height=500,resizable=yes,scrollbars=1,menubar=yes,');">Links</a>&#160;]<!-- end-ref --> ]]></body><back>
<ref-list>
<ref id="B1">
<label>1</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Warner]]></surname>
<given-names><![CDATA[SL]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Randomized response: a survey technique for eliminating evasive answer bias]]></article-title>
<source><![CDATA[Journal of the American Statistical Association]]></source>
<year>1965</year>
<volume>60</volume>
<numero>309</numero>
<issue>309</issue>
<page-range>63-69</page-range></nlm-citation>
</ref>
<ref id="B2">
<label>2</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Warner]]></surname>
<given-names><![CDATA[SL]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The Linear Randomized Response Model]]></article-title>
<source><![CDATA[Journal of the American Statistical Association]]></source>
<year>1971</year>
<volume>66</volume>
<numero>336</numero>
<issue>336</issue>
<page-range>884-888</page-range></nlm-citation>
</ref>
<ref id="B3">
<label>3</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Greenberg]]></surname>
<given-names><![CDATA[BG]]></given-names>
</name>
<name>
<surname><![CDATA[Abul-Ela]]></surname>
<given-names><![CDATA[Abdel-Latif A]]></given-names>
</name>
<name>
<surname><![CDATA[Simmons]]></surname>
<given-names><![CDATA[WR]]></given-names>
</name>
<name>
<surname><![CDATA[Horvitz]]></surname>
<given-names><![CDATA[DG]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The Unrelated Question Randomized Response Model: Theoretical Framework]]></article-title>
<source><![CDATA[Journal of the American Statistical Association]]></source>
<year>1969</year>
<volume>64</volume>
<numero>326</numero>
<issue>326</issue>
<page-range>520-539</page-range></nlm-citation>
</ref>
<ref id="B4">
<label>4</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Lamb Jr]]></surname>
<given-names><![CDATA[CW]]></given-names>
</name>
<name>
<surname><![CDATA[Stem Jr]]></surname>
<given-names><![CDATA[DE]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[An Empirical Validation of the Randomized Response Technique]]></article-title>
<source><![CDATA[Journal of Marketing Research]]></source>
<year>1978</year>
<volume>15</volume>
<numero>4</numero>
<issue>4</issue>
<page-range>616-621</page-range></nlm-citation>
</ref>
<ref id="B5">
<label>5</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Campbell]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Randomized Response Technique]]></article-title>
<source><![CDATA[Science]]></source>
<year>1987</year>
<volume>236</volume>
<numero>4805</numero>
<issue>4805</issue>
<page-range>1049</page-range></nlm-citation>
</ref>
<ref id="B6">
<label>6</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Tracy]]></surname>
<given-names><![CDATA[P]]></given-names>
</name>
<name>
<surname><![CDATA[Fox]]></surname>
<given-names><![CDATA[JA]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[The Validity of Randomized Response for Sensitive Measurements]]></article-title>
<source><![CDATA[American Sociological Review]]></source>
<year>1981</year>
<volume>46</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>187-200</page-range></nlm-citation>
</ref>
<ref id="B7">
<label>7</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Miller]]></surname>
<given-names><![CDATA[JD]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Complexities of the Randomized Response Solution]]></article-title>
<source><![CDATA[American Sociological Review]]></source>
<year>1981</year>
<volume>46</volume>
<numero>6</numero>
<issue>6</issue>
<page-range>928-930</page-range></nlm-citation>
</ref>
<ref id="B8">
<label>8</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Bourke]]></surname>
<given-names><![CDATA[PD]]></given-names>
</name>
<name>
<surname><![CDATA[Dalenius]]></surname>
<given-names><![CDATA[T]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Some New Ideas in the Realm of Randomized Inquiries]]></article-title>
<source><![CDATA[International Statistical Review / Revue Internationale de Statistique]]></source>
<year>1976</year>
<volume>44</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>219-221</page-range></nlm-citation>
</ref>
<ref id="B9">
<label>9</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Greenberg]]></surname>
<given-names><![CDATA[BG]]></given-names>
</name>
<name>
<surname><![CDATA[Abul-Ela]]></surname>
<given-names><![CDATA[Abdel-Latif A]]></given-names>
</name>
<name>
<surname><![CDATA[Simmons]]></surname>
<given-names><![CDATA[WR]]></given-names>
</name>
<name>
<surname><![CDATA[Horvitz]]></surname>
<given-names><![CDATA[DG]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[A Multi-Proportions Randomized Response Model]]></article-title>
<source><![CDATA[Journal of the American Statistical Association]]></source>
<year>1967</year>
<volume>62</volume>
<numero>319</numero>
<issue>319</issue>
<page-range>990-1008</page-range></nlm-citation>
</ref>
<ref id="B10">
<label>10</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Mangat]]></surname>
<given-names><![CDATA[NS]]></given-names>
</name>
<name>
<surname><![CDATA[Singh]]></surname>
<given-names><![CDATA[R]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[An Alternative Randomized Response Procedure]]></article-title>
<source><![CDATA[Biometrika]]></source>
<year>1990</year>
<volume>77</volume>
<numero>2</numero>
<issue>2</issue>
<page-range>439-442</page-range></nlm-citation>
</ref>
<ref id="B11">
<label>11</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Mangat]]></surname>
<given-names><![CDATA[NS]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[An Improved Randomized Response Strategy]]></article-title>
<source><![CDATA[Journal of the Royal Statistical Society. Series B (Methodological)]]></source>
<year>1994</year>
<volume>56</volume>
<numero>1</numero>
<issue>1</issue>
<page-range>93-95</page-range></nlm-citation>
</ref>
<ref id="B12">
<label>12</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[O'Hagan]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bayes Linear Estimators for Randomized Response Models]]></article-title>
<source><![CDATA[Journal of the American Statistical Association]]></source>
<year>1987</year>
<volume>82</volume>
<numero>398</numero>
<issue>398</issue>
<page-range>580-585</page-range></nlm-citation>
</ref>
<ref id="B13">
<label>13</label><nlm-citation citation-type="">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Winkler]]></surname>
<given-names><![CDATA[RL]]></given-names>
</name>
<name>
<surname><![CDATA[Gaba]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Inference With Imperfect Sampling From Bernoulli Process]]></article-title>
<person-group person-group-type="editor">
<name>
<surname><![CDATA[Geisser]]></surname>
<given-names><![CDATA[S]]></given-names>
</name>
<name>
<surname><![CDATA[Hodges]]></surname>
<given-names><![CDATA[J]]></given-names>
</name>
<name>
<surname><![CDATA[Press]]></surname>
<given-names><![CDATA[S.J]]></given-names>
</name>
<name>
<surname><![CDATA[Zellner]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<source><![CDATA[Bayesian and Likelihood Methods in Statistics and Econometrics: Essays in Honor of George A. Barnard]]></source>
<year>1990</year>
<page-range>303-317</page-range><publisher-loc><![CDATA[Amsterdam ]]></publisher-loc>
</nlm-citation>
</ref>
<ref id="B14">
<label>14</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Stamey]]></surname>
<given-names><![CDATA[JD]]></given-names>
</name>
<name>
<surname><![CDATA[Seaman]]></surname>
<given-names><![CDATA[JW]]></given-names>
</name>
<name>
<surname><![CDATA[Young]]></surname>
<given-names><![CDATA[DM]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bayesian analysis of complementary Poisson rate parameters with data subject to misclassification]]></article-title>
<source><![CDATA[Journal of Statistical Planning and Inference]]></source>
<year>2005</year>
<numero>134</numero>
<issue>134</issue>
<page-range>36-48</page-range></nlm-citation>
</ref>
<ref id="B15">
<label>15</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Boese]]></surname>
<given-names><![CDATA[DH]]></given-names>
</name>
<name>
<surname><![CDATA[Young]]></surname>
<given-names><![CDATA[DH]]></given-names>
</name>
<name>
<surname><![CDATA[Stamey]]></surname>
<given-names><![CDATA[JD]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Confidence intervals for a binomial parameter base don binary data subject to false-positive misclassification]]></article-title>
<source><![CDATA[Computational Statistics & Data Analysis]]></source>
<year>2006</year>
<numero>50</numero>
<issue>50</issue>
<page-range>3369-3385</page-range></nlm-citation>
</ref>
<ref id="B16">
<label>16</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Lee]]></surname>
<given-names><![CDATA[SC]]></given-names>
</name>
<name>
<surname><![CDATA[Byun]]></surname>
<given-names><![CDATA[JS]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bayesian approach to obtain confidence intervals for binomial proportion in a double sampling scheme subject to false-positive misclassification]]></article-title>
<source><![CDATA[Journal of the Korean Statistical Society]]></source>
<year>2008</year>
<numero>37</numero>
<issue>37</issue>
<page-range>393-403</page-range></nlm-citation>
</ref>
<ref id="B17">
<label>17</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Rahardja]]></surname>
<given-names><![CDATA[D]]></given-names>
</name>
<name>
<surname><![CDATA[Zhao]]></surname>
<given-names><![CDATA[YD]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Bayesian inference of a binomial porportion using one simple misclassified binary data]]></article-title>
<source><![CDATA[Model Assisted Statistics and Applications]]></source>
<year>2012</year>
<volume>7</volume>
<numero>1</numero>
<issue>1</issue>
<page-range>17-22</page-range></nlm-citation>
</ref>
<ref id="B18">
<label>18</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Gaba]]></surname>
<given-names><![CDATA[A]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Inferences with an Unknown Noise Level in a Bernoulli Process]]></article-title>
<source><![CDATA[Managment Science]]></source>
<year>1993</year>
<volume>39</volume>
<numero>10</numero>
<issue>10</issue>
<page-range>1227-1237</page-range></nlm-citation>
</ref>
<ref id="B19">
<label>19</label><nlm-citation citation-type="journal">
<person-group person-group-type="author">
<name>
<surname><![CDATA[Casella]]></surname>
<given-names><![CDATA[G]]></given-names>
</name>
<name>
<surname><![CDATA[George]]></surname>
<given-names><![CDATA[Edward I]]></given-names>
</name>
</person-group>
<article-title xml:lang="en"><![CDATA[Explaining the Gibbs Sampler]]></article-title>
<source><![CDATA[The American Statistician]]></source>
<year>1992</year>
<volume>46</volume>
<numero>3</numero>
<issue>3</issue>
<page-range>167-174</page-range></nlm-citation>
</ref>
</ref-list>
</back>
</article>